Redis詳解(十二)—— 緩存穿透、緩存擊穿、緩存雪崩_貨運

※評比南投搬家公司費用收費行情懶人包大公開

搬家價格與搬家費用透明合理,不亂收費。本公司提供下列三種搬家計費方案,由資深專業組長到府估價,替客戶量身規劃選擇最經濟節省的計費方式

  本篇博客我們來介紹Redis使用過程中需要注意的三種問題:緩存穿透、緩存擊穿、緩存雪崩。

1、緩存穿透

一、概念

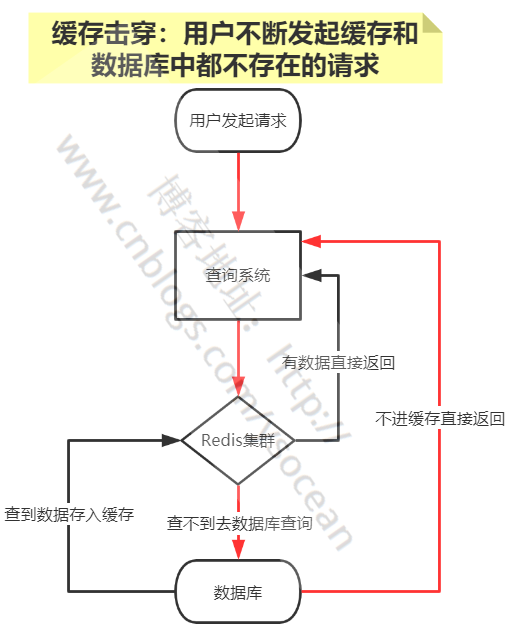
  緩存穿透:緩存和數據庫中都沒有的數據,可用戶還是源源不斷的發起請求,導致每次請求都會到數據庫,從而壓垮數據庫。

  如下圖紅色的流程:


   比如客戶查詢一個根本不存在的東西,首先從Redis中查不到,然後會去數據庫中查詢,數據庫中也查詢不到,那麼就不會將數據放入到緩存中,後面如果還有類似源源不斷的請求,最後都會壓到數據庫來處理,從而給數據庫造成巨大的壓力。

二、解決辦法

  ①、業務層校驗

  用戶發過來的請求,根據請求參數進行校驗,對於明顯錯誤的參數,直接攔截返回。

  比如,請求參數為主鍵自增id,那麼對於請求小於0的id參數,明顯不符合,可以直接返回錯誤請求。

  ②、不存在數據設置短過期時間

  對於某個查詢為空的數據,可以將這個空結果進行Redis緩存,但是設置很短的過期時間,比如30s,可以根據實際業務設定。注意一定不要影響正常業務。

  ③、布隆過濾器

  關於布隆過濾器,後面會詳細介紹。布隆過濾器是一種數據結構,利用極小的內存,可以判斷大量的數據“一定不存在或者可能存在”。

  對於緩存擊穿,我們可以將查詢的數據條件都哈希到一個足夠大的布隆過濾器中,用戶發送的請求會先被布隆過濾器攔截,一定不存在的數據就直接攔截返回了,從而避免下一步對數據庫的壓力。

2、緩存擊穿

一、概念

  緩存擊穿:Redis中一個熱點key在失效的同時,大量的請求過來,從而會全部到達數據庫,壓垮數據庫。


   這裏要注意的是這是某一個熱點key過期失效,和後面介紹緩存雪崩是有區別的。比如淘寶雙十一,對於某個特價熱門的商品信息,緩存在Redis中,剛好0點,這個商品信息在Redis中過期查不到了,這時候大量的用戶又同時正好訪問這個商品,就會造成大量的請求同時到達數據庫。

二、解決辦法

  ①、設置熱點數據永不過期

※智慧手機時代的來臨,RWD網頁設計為架站首選

網動結合了許多網際網路業界的菁英共同研發簡單易操作的架站工具,及時性的更新,為客戶創造出更多的網路商機。

  對於某個需要頻繁獲取的信息,緩存在Redis中,並設置其永不過期。當然這種方式比較粗暴,對於某些業務場景是不適合的。

  ②、定時更新

  比如這個熱點數據的過期時間是1h,那麼每到59minutes時,通過定時任務去更新這個熱點key,並重新設置其過期時間。

  ③、互斥鎖

  這是解決緩存穿透比較常用的方法。

  互斥鎖簡單來說就是在Redis中根據key獲得的value值為空時,先鎖上,然後從數據庫加載,加載完畢,釋放鎖。若其他線程也在請求該key時,發現獲取鎖失敗,則睡眠一段時間(比如100ms)后重試。

3、緩存雪崩

一、概念

  緩存雪崩:Redis中緩存的數據大面積同時失效,或者Redis宕機,從而會導致大量請求直接到數據庫,壓垮數據庫。


   對於一個業務系統,如果Redis宕機或大面積的key同時過期,會導致大量請求同時打到數據庫,這是災難性的問題。

二、解決辦法

  ①、設置有效期均勻分佈

  避免緩存設置相近的有效期,我們可以在設置有效期時增加隨機值;

  或者統一規劃有效期,使得過期時間均勻分佈。

  ②、數據預熱

  對於即將來臨的大量請求,我們可以提前走一遍系統,將數據提前緩存在Redis中,並設置不同的過期時間。

  ③、保證Redis服務高可用

  前面我們介紹過Redis的哨兵模式和集群模式,為防止Redis集群單節點故障,可以通過這兩種模式實現高可用。


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※回頭車貨運收費標準

宇安交通關係企業,自成立迄今,即秉持著「以誠待人」、「以實處事」的企業信念

談反應式編程在服務端中的應用,數據庫操作優化,萬條記錄從20秒到0.5秒_網頁設計公司

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

節能減碳愛地球是景泰電動車的理念,是創立景泰電動車行的初衷,滿意態度更是服務客戶的最高品質,我們的成長來自於你的推薦。

反應式編程在客戶端編程當中的應用相當廣泛,而當前在服務端中的應用相對被提及較少。本篇將介紹如何在服務端編程中應用響應時編程來改進數據庫操作的性能。

開篇就是結論

利用 System.Reactive 配合 TaskCompelteSource ,可以將分散的單次數據庫插入請求合併會一個批量插入的請求。在確保正確性的前提下,實現數據庫插入性能的優化。

如果讀者已經了解了如何操作,那麼剩下的內容就不需要再看了。

預設條件

現在,我們假設存在這樣一個 Repository 接口來表示一次數據庫的插入操作。

  csharp

namespace Newbe.RxWorld.DatabaseRepository { public interface IDatabaseRepository { /// <summary> /// Insert one item and return total count of data in database /// </summary> /// <param name="item"></param> /// <returns></returns> Task<int> InsertData(int item); } }

接下來,我們在不改變該接口簽名的前提下,體驗一下不同的實現帶來的性能區別。

基礎版本

首先是基礎版本,採用的是最為常規的單次數據庫INSERT操作來完成數據的插入。本示例採用的是SQLite作為演示數據庫,方便讀者自行實驗。

  csharp

namespace Newbe.RxWorld.DatabaseRepository.Impl { public class NormalDatabaseRepository : IDatabaseRepository { private readonly IDatabase _database; public NormalDatabaseRepository( IDatabase database) { _database = database; } public Task<int> InsertData(int item) { return _database.InsertOne(item); } } }

常規操作。其中_database.InsertOne(item)的具體實現就是調用了一次INSERT。

基礎版本在同時插入小於20次時基本上可以較快的完成。但是如果數量級增加,例如需要同時插入一萬條數據庫,將會花費約20秒鐘,存在很大的優化空間。

TaskCompelteSource

TaskCompelteSource 是 TPL 庫中一個可以生成一個可操作 Task 的類型。對於 TaskCompelteSource 不太熟悉的讀者可以通過該實例代碼了解。

此處也簡單解釋一下該對象的作用,以便讀者可以繼續閱讀。

對於熟悉 javascript 的朋友,可以認為 TaskCompelteSource 相當於 Promise 對象。也可以相當於 jQuery 當中的 $.Deferred 。

如果都不了解的朋友,可以聽一下筆者吃麻辣燙時想到的生活化例子。

吃麻辣燙 技術解釋
吃麻辣燙之前,需要先用盤子夾菜。 構造參數
夾好菜之後,拿到結賬處去結賬 調用方法
收銀員結賬完畢之後,會得到一個叫餐牌,會響鈴的那種 得到一個 Task 返回值
拿着菜牌找了一個位子坐下,玩手機等餐 正在 await 這個 Task ,CPU轉而處理其他事情
餐牌響了,去取餐,吃起來 Task 完成,await 節數,繼續執行下一行代碼

那麼 TaskCompelteSource 在哪兒呢?

首先,根據上面的例子,在餐牌響的時候,我們才會去取餐。那麼餐牌什麼時候才會響呢?當然是服務員手動按了一個在櫃檯的手動開關才觸發了這個響鈴。

那麼,櫃檯的這個開關,可以被技術解釋為 TaskCompelteSource 。

餐台開關可以控制餐牌的響鈴。同樣, TaskCompelteSource 就是一種可以控制 Task 的狀態的對象。

解決思路

有了前面對 TaskCompelteSource 的了解,那麼接下來就可以解決文章開頭的問題了。思路如下:

當調用 InsertData 時,可以創建一個 TaskCompelteSource 以及 item 的元組。為了方便說明,我們將這個元組命名為BatchItem。

將 BatchItem 的 TaskCompelteSource 對應的 Task 返回出去。

※南投搬家公司費用,距離,噸數怎麼算?達人教你簡易估價知識!

搬家費用:依消費者運送距離、搬運樓層、有無電梯、步行距離、特殊地形、超重物品等計價因素後,評估每車次單

調用 InsertData 的代碼會 await 返回的 Task,因此只要不操作 TaskCompelteSource ,調用者就一會一直等待。

然後,另外啟動一個線程,定時將 BatchItem 隊列消費掉。

這樣就完成了單次插入變為批量插入的操作。

筆者可能解釋的不太清楚,不過以下所有版本的代碼均基於以上思路。讀者可以結合文字和代碼進行理解。

ConcurrentQueue 版本

基於以上的思路,我們採用 ConcurrentQueue 作為 BatchItem 隊列進行實現,代碼如下(代碼很多,不必糾結,因為下面還有更簡單的):

  csharp

namespace Newbe.RxWorld.DatabaseRepository.Impl { public class ConcurrentQueueDatabaseRepository : IDatabaseRepository { private readonly ITestOutputHelper _testOutputHelper; private readonly IDatabase _database; private readonly ConcurrentQueue<BatchItem> _queue; // ReSharper disable once PrivateFieldCanBeConvertedToLocalVariable private readonly Task _batchInsertDataTask; public ConcurrentQueueDatabaseRepository( ITestOutputHelper testOutputHelper, IDatabase database) { _testOutputHelper = testOutputHelper; _database = database; _queue = new ConcurrentQueue<BatchItem>(); // 啟動一個 Task 消費隊列中的 BatchItem _batchInsertDataTask = Task.Factory.StartNew(RunBatchInsert, TaskCreationOptions.LongRunning); _batchInsertDataTask.ConfigureAwait(false); } public Task<int> InsertData(int item) { // 生成 BatchItem ,將對象放入隊列。返回 Task 出去 var taskCompletionSource = new TaskCompletionSource<int>(); _queue.Enqueue(new BatchItem { Item = item, TaskCompletionSource = taskCompletionSource }); return taskCompletionSource.Task; } // 從隊列中不斷獲取 BatchItem ,並且一批一批插入數據庫,更新 TaskCompletionSource 的狀態 private void RunBatchInsert() { foreach (var batchItems in GetBatches()) { try { BatchInsertData(batchItems).Wait(); } catch (Exception e) { _testOutputHelper.WriteLine($"there is an error : {e}"); } } IEnumerable<IList<BatchItem>> GetBatches() { var sleepTime = TimeSpan.FromMilliseconds(50); while (true) { const int maxCount = 100; var oneBatchItems = GetWaitingItems() .Take(maxCount) .ToList(); if (oneBatchItems.Any()) { yield return oneBatchItems; } else { Thread.Sleep(sleepTime); } } IEnumerable<BatchItem> GetWaitingItems() { while (_queue.TryDequeue(out var item)) { yield return item; } } } } private async Task BatchInsertData(IEnumerable<BatchItem> items) { var batchItems = items as BatchItem[] ?? items.ToArray(); try { // 調用數據庫的批量插入操作 var totalCount = await _database.InsertMany(batchItems.Select(x => x.Item)); foreach (var batchItem in batchItems) { batchItem.TaskCompletionSource.SetResult(totalCount); } } catch (Exception e) { foreach (var batchItem in batchItems) { batchItem.TaskCompletionSource.SetException(e); } throw; } } private struct BatchItem { public TaskCompletionSource<int> TaskCompletionSource { get; set; } public int Item { get; set; } } } }
以上代碼中使用了較多的 Local Function 和 IEnumerable 的特性,不了解的讀者可以點擊此處進行了解。

正片開始!

接下來我們使用 System.Reactive 來改造上面較為複雜的 ConcurrentQueue 版本。如下:

  csharp

namespace Newbe.RxWorld.DatabaseRepository.Impl { public class AutoBatchDatabaseRepository : IDatabaseRepository { private readonly ITestOutputHelper _testOutputHelper; private readonly IDatabase _database; private readonly Subject<BatchItem> _subject; public AutoBatchDatabaseRepository( ITestOutputHelper testOutputHelper, IDatabase database) { _testOutputHelper = testOutputHelper; _database = database; _subject = new Subject<BatchItem>(); // 將請求進行分組,每50毫秒一組或者每100個一組 _subject.Buffer(TimeSpan.FromMilliseconds(50), 100) .Where(x => x.Count > 0) // 將每組數據調用批量插入,寫入數據庫 .Select(list => Observable.FromAsync(() => BatchInsertData(list))) .Concat() .Subscribe(); } // 這裏和前面對比沒有變化 public Task<int> InsertData(int item) { var taskCompletionSource = new TaskCompletionSource<int>(); _subject.OnNext(new BatchItem { Item = item, TaskCompletionSource = taskCompletionSource }); return taskCompletionSource.Task; } // 這段和前面也完全一樣,沒有變化 private async Task BatchInsertData(IEnumerable<BatchItem> items) { var batchItems = items as BatchItem[] ?? items.ToArray(); try { var totalCount = await _database.InsertMany(batchItems.Select(x => x.Item)); foreach (var batchItem in batchItems) { batchItem.TaskCompletionSource.SetResult(totalCount); } } catch (Exception e) { foreach (var batchItem in batchItems) { batchItem.TaskCompletionSource.SetException(e); } throw; } } private struct BatchItem { public TaskCompletionSource<int> TaskCompletionSource { get; set; } public int Item { get; set; } } } }

代碼減少了 50 行,主要原因就是使用 System.Reactive 中提供的很強力的 Buffer 方法實現了 ConcurrentQueue 版本中的複雜的邏輯實現。

老師,可以更給力一點嗎?

我們,可以“稍微”優化一下代碼,將 Buffer 以及相關的邏輯獨立於“數據庫插入”這個業務邏輯。那麼我們就會得到一個更加簡單的版本:

  csharp

namespace Newbe.RxWorld.DatabaseRepository.Impl { public class FinalDatabaseRepository : IDatabaseRepository { private readonly IBatchOperator<int, int> _batchOperator; public FinalDatabaseRepository( IDatabase database) { var options = new BatchOperatorOptions<int, int> { BufferTime = TimeSpan.FromMilliseconds(50), BufferCount = 100, DoManyFunc = database.InsertMany, }; _batchOperator = new BatchOperator<int, int>(options); } public Task<int> InsertData(int item) { return _batchOperator.CreateTask(item); } } }

其中 IBatchOperator 等代碼,讀者可以到代碼庫中進行查看,此處就不在陳列了。

性能測試

基本可以測定如下:

在 10 條數據併發操作時,原始版本和批量版本沒有多大區別。甚至批量版本在數量少時會更慢,畢竟其中存在一個最大 50 毫秒的等待時間。

但是,如果需要批量操作併發操作一萬條數據,那麼原始版本可能需要消耗20秒,而批量版本僅僅只需要0.5秒。

所有的示例代碼均可以在代碼庫中找到。如果 Github Clone 存在困難,也可以點擊此處從 Gitee 進行 Clone

最後但是最重要!

最近作者正在構建以反應式、Actor模式和事件溯源為理論基礎的一套服務端開發框架。希望為開發者提供能夠便於開發出“分佈式”、“可水平擴展”、“可測試性高”的應用系統——Newbe.Claptrap

本篇文章是該框架的一篇技術選文,屬於技術構成的一部分。如果讀者對該內容感興趣,歡迎轉發、評論、收藏文章以及項目。您的支持是促進項目成功的關鍵。

當前項目已經快要發布 0.1 alpha 版本,歡迎參与討論。

GitHub 項目地址:https://github.com/newbe36524/Newbe.Claptrap

Gitee 項目地址:https://gitee.com/yks/Newbe.Claptrap

文章作者: newbe36524
本文章著作權歸作者所有,任何形式的轉載都請註明出處。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

透過選單樣式的調整、圖片的縮放比例、文字的放大及段落的排版對應來給使用者最佳的瀏覽體驗,所以不用擔心有手機版網站兩個後台的問題,而視覺效果也是透過我們前端設計師優秀的空間比例設計,不會因為畫面變大變小而影響到整體視覺的美感。

大學四年自學走來,這些私藏的實用工具/學習網站我貢獻出來了_租車

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

有別於一般網頁架設公司,除了模組化的架站軟體,我們的營業主軸還包含:資料庫程式開發、網站建置、網頁設計、電子商務專案開發、系統整合、APP設計建置、專業網路行銷。

點贊再看,養成習慣,微信搜索【敖丙】關注這個互聯網苟且偷生的工具人。

本文 GitHub https://github.com/JavaFamily 已收錄,有一線大廠面試完整考點、資料以及我的系列文章。

##前言

在大學的時候我們有大量的業餘時間,我們可以拿出一部分時間去自學,也可以自學你感興趣的非你本專業的內容,就比如舞蹈,畫畫,等等,我就是在B站舞蹈區經常看欣小萌,咬人喵學習舞蹈,咳咳。

當然如果你成績不理想或者想更上一層,也可以去利用業餘事假給自己的當前的專業知識補補課。

我大學本身的專業是电子信息工程比較偏硬件的,後面通過在圖書館一年的自學,拿了不少獎,也在大二就收穫了某大廠的offer,現在自己走軟件這條路也是通過自學走過來的,如果大家對我當時軟件的學習方法和學習路線感情去,我後面可以單獨出一期,本期主要是說一些我覺得不錯的一些學習工具和網站。

正所謂工欲善其事必先利其器嘛,好的工具往往可以讓你事半功倍,首先我介紹的了呢,就是B站。

B站

網址:www.bilibili.com

這真的是一個學習網站,上面提到的咬人喵,欣小萌等等真的好看,咳咳 扯回正題,B站上面有很多優秀的up主,大家在這裏可以學到各行各業豐富的專業知識,在下海前,呸呸呸入海前,在這裏武裝自己也是極好的。

何同學大家都知道吧,我很早就關注了他,我最早是關注他學剪輯的你敢信?總之很多不錯的up大家真的值得關注像他們學習。

中國大學MOOC

網址:www.icourse163.org

這是我在大學自學c語言和計算機基礎的地方,學校有相關課程,但是我容易走神,所以我一般會選擇在這裏補課,是一個非常良心的免費學習網站,裏面主要是大學相關課程的視頻,什麼類型的都有。

現在我都還記得浙江大學的翁愷老師,當時我就在學校感慨,這個男人怎麼這麼有魅力。

IMOOC

網址:www.imooc.com

慕課網主要就是互聯網IT一類的課程,大部分都是付費的,號稱程序員的夢工廠。

我之前在裏面看過Linux相關的課程,整體的課程質量還是不錯的,如果你是個還在迷茫的學生,又或者是在考慮是否轉行的工作人員,請你耐心看完,相信會對你有所幫助!

極客時間

網址:https://time.geekbang.org

所有內容都是收費的,但是課程質量一樣很高,特別是我看過的丁奇的MySQL47講,裏面大部分的老師都是相關領域的技術專家。

之前我們公司的技術總監趙成花名謙益,就有在上面寫運維相關的專欄,因為他也是我的朋友,所以我也知道他寫一篇專欄需要耗費的時間和精力。

所以也是很值得推薦的一個學習網站。

極客學院

網址:www.jikexueyuan.com

有免費,有收費的課程,成為會員也比較簡單,讓朋友幫忙點擊鏈接就好了,課程質量也是不錯的。

網易雲課堂

網址:https://study.163.com

內容不局限於程序員,ui產品都有,大家比較迷茫可以可以看看。

百度/谷歌

網址:www.baidu.com www.google.com

搜索引擎嘛,想廣告少點就谷歌吧。

知乎

網址:www.zhihu.com

知乎,大家的刻板印象可能就是裝逼的地方,說實話我也經常在上面裝逼,但是如果你想在上面學習知識,這完全也是個很好的學習網站,同樣有很多不錯的博主會在上面分享自己的經驗經歷和相關的專業知識,你就去看贊高的就好了,我覺得也是很值得大家使用的網站。

GitHub

網址:https://github.com

程序員男生居多所以用戶也是男生居多,用戶來自全球,號稱gayhub全球最大的同性交友網站啊,很多開源網站,你要的畢設或許就可以在上面找到,搞不好還帶論文。

所有的開源項目,都在這裏託管,想看源碼,或者各種知識點的總結,這裏都有,我訂閱了官網的熱門,發現比較優秀的開源項目,都會搞下來看看到底有沒有東西。

也有很多博主比如我看一下我的GitHub,就收集了我寫的文章,還有我整理的學習資料等等。

我要自學網

網址:www.51zw.net

我要自學網是由來自電腦培訓學校和職業高校的老師聯手創立的一個視頻教學網,網站里的視頻教程均由經驗豐富的在職老師原創錄製,同時提供各類貼心服務,讓大家享受一站式的學習體驗。

我當時學了一些ps的東西,就是在這上面看的。

w3school、菜鳥教程

網址:www.w3school.com.cn www.runoob.com

領先的Web技術教程,在w3school,你可以找到你所需要的所有的網站建設教程,我主要當工具查詢網站了。

豆瓣、微信讀書、噹噹

網址:www.douban.com https://weread.qq.com http://book.dangdang.com

萬般皆下品惟有讀書高、書中自有黃金屋、黑髮不知勤學早,白首方悔讀書遲。

我想關於描寫讀書的諺語都不用我在過多的贅述了,讀書我想也只有好處,沒有壞處的,還是那句話,作者都是把自己幾年甚至幾十年的總結,都在寫在了書里,就算有錯誤的點,大的方向大家還是能收穫東西的。

了解一個新的知識點,技術棧,看書是不二之選,我個人也比較推薦看書,看書的時候你的心會沒那麼浮躁,其實看一本書你規定每天看十幾頁,一本300頁的書,也一個月不到就完了,很是很快的,根本不浪費大家多少時間。

那大家不知道書的好壞,買之前可以去噹噹或者京東看看對應的評價,或者去豆瓣看書評,我個人是豆瓣看得多點。

CSDN

www.csdn.net

這個也是我姐姐在推薦我看技術博客的時候,一起給我推薦的,不過在姐姐推薦之前,我其實就已經在使用他了,他有資源共享下載的地方,雖然要花C幣,我還記得大學為了幾C幣去各種求網友的場景。

他是1999年成立的,算是國內最老,最成熟的技術博客網站了,內容無比豐富,底蘊很深厚,註冊會員是千萬級別的,他的SEO也做的很好,所以百度你查資料基本上就是他和博客園置頂了。

掘金

https://juejin.im

是一個幫助開發者成長的社區,是一個面向互聯網技術人的內容分享平台,是的社區這兩個字很醒目,這也是我個人認為掘金的最大特點,15成立的他很年輕,我是在大學的時候我姐姐推薦給我的。

當然你現在也知道了我也經常在掘金髮文,從一個知識攝入者,變成了一個知識的分享者,他社區的特點一覽無遺,是一個很包容的平台,裏面前端到後端我覺得界限沒別的平台那麼明顯,說他是社區是因為,他有分享生活,分享技術的種種文章,沸點甚至有種看朋友圈的特點。

博客園

網址:www.cnblogs.com

昂,上面剛提到的博客園,04年的他,比起CSDN年輕了不少,是一個以.net為主的博客網站,這麼多年風格變化不是很大,至少在大學接觸他到現在這麼久了,都沒怎麼變。

移動端這麼重要的今天,他的移動端,還是那麼下飯,我不知道怎麼想的哈哈,不過問題不大,因為他復古的界面,以及他極度DIY的風格定義,導致他有一批死忠粉和老用戶,也是很活躍的博客網站。

思否(segmentfault)

網址:https://segmentfault.com

說到回答,這個跟我一樣是杭漂的網站就厲害了,他也是博客和問答的形式,是中國版的stackoverflow,不過因為他的年輕,可能沉澱的文章還不夠,不過我想會越來越好的。

stackoverflow

網址:https://stackoverflow.com

上面既然提到了中國版的,我就說一下這個世界級別的老大哥,這是我這裏面使用頻率很高的網站了,遇到問題不會就Google,然後基本上都往這裏面跳,你就知道他的厲害了。

是的你遇到的問題,外國的友人肯定也有遇到的,問答的方式,還有很多熱血仔在下面跟答的形式,我比較喜歡,而且國外大牛多嘛。

開源中國

網址:www.oschina.net

跟碼雲是一家的,作為博客網站來說,年輕了點,但是不影響他有很多優質的博主不斷給他輸出內容,基本上的領域都覆蓋了,經常也會舉辦各種活動,我也看好他的未來。

V2ex

網址:www.v2ex.com

v2ex,是一個彙集各類奇妙好玩的話題和流行動向的網站。V2EX 提供了特別有用的小工具 [ ZEN ],V2EX 中充滿了各種各樣精心雕琢的細節。

infoQ

網址:www.infoq.cn

※超省錢租車方案

商務出差、學生出遊、旅遊渡假、臨時用車!GO 神州租賃有限公司!合法經營、合法連鎖、合法租賃小客車!

InfoQ(Information Queue)是一個在線新聞/社區網站,旨在通過促進軟件開發領域知識與創新的傳播,為軟件開發者提供幫助,文章質量特別高,但是需要一定的專業基礎知識讀起來才有意思。

有道詞典

網址:www.youdao.com

查單詞,我英語是真的菜,基本上都是一直開着的。

印象筆記

網址:www.yinxiang.com

個人用的印象筆記,從大學到現在用了很多年了,還是很不錯的,也承載了我的很多記憶,基本上有我學硬件,到學軟件這一路的筆記了,也有一些婆娑的日記,我是話癆來的嘛,這個習慣我覺得還是挺不錯的,至少寫筆記這個習慣讓我現在寫文章也算是比較從容。

他的插件也很好用,可以直接保存網頁信息到筆記,不用怕到時候找不到,或者作者刪除了。

如果大家不想安裝,想直接使用雲的,他也有,或者你可以嘗試以下兩個。

有道雲、石墨文檔

網址:https://note.youdao.com https://shimo.im

這兩個是我使用比較頻繁的雲筆記工具,主要是在線嘛,方便。

ProcessOn 、xmind

網址:www.processon.com www.xmind.cn

這個是我工作以來,一直都很依賴的工作和學習的方式,就是做腦圖,工作中大家也會發現身邊的仔,基本上也都會或多或少的做一些腦圖,去輔助自己設計系統,或者去了解學習一些知識點什麼的。

他可以做詳細設計,做概要設計,當然也可以做我上面提到的時間規劃,以及知識點清單啥的。

鳩摩搜索

網址:www.jiumodiary.com

這個網址可以用來搜索一些pdf的書,有了這個網址,就不用百度全網搜索pdf的書了。雖然可能沒有像百度全網搜索那麼全,但大部分也都有了。注意每種搜索結果的來源,有些來源是百度雲盤,有些是微盤等,可以根據需要獲取。

腳本之家

網址:www.jb51.net/books

腳本之家資源還是挺多的,电子書其中之一,不過,也是有挺多电子書的,並且提供多種下載方式,如果你鳩摩搜書搜索不到,或許可以考慮在腳本之家搜索,或者腳本之家搜索不到就到鳩摩搜書搜索。

牛客網 校招

網址:www.nowcoder.com

我沒經歷過校招,但是我確實在上面刷過計算機相關的題目,也有各大互聯網公司的面試真題,還有一些學長在上面發麵經,內推信息等等,大家都可以提前去看看,聯繫自己想去公司的學長,讓他幫你內推

LeetCode、lintcode

網址:https://leetcode-cn.com www.lintcode.com

算算法題目的,我算法很差,後悔沒好好刷了,大家想去字節這樣的公司是一定要刷的。

數據結構模擬

網址:https://www.cs.usfca.edu

大家如果對一些數據結構感覺很抽象,那這個網站可以幫助你,比如二叉樹紅黑樹,在這裏都能模擬數據的插入刪除。

BOSS、拉鈎

網址:www.zhipin.com www.lagou.com

什麼都學好了,找工作當然也得需要一個投遞簡歷的好網站,我這裏就推薦boss和拉鈎,這兩個也是我出去找工作會經常使用的兩個網站,boss效率會高很多。

總結

文中提到的所有網址:

B站 網址:www.bilibili.com

中國大學MOOC 網址:www.icourse163.org

IMOOC 網址:www.imooc.com

極客時間 網址:https://time.geekbang.org

極客學院 網址:www.jikexueyuan.com

網易雲課堂 網址:https://study.163.com

百度/谷歌 網址:www.baidu.com www.google.com

知乎 網址:www.zhihu.com

GitHub 網址:https://github.com

我要自學網 網址:www.51zw.net

w3school、菜鳥教程 網址:www.w3school.com.cn www.runoob.com

豆瓣、微信讀書、噹噹 網址:www.douban.com https://weread.qq.com http://book.dangdang.com

CSDN 網址www.csdn.net

掘金 網址 https://juejin.im

博客園 網址:www.cnblogs.com

思否(segmentfault) 網址:https://segmentfault.com

stackoverflow 網址:https://stackoverflow.com

開源中國 網址:www.oschina.net

V2ex 網址:www.v2ex.com

infoQ 網址:www.infoq.cn

有道詞典 網址:www.youdao.com

印象筆記 網址:www.yinxiang.com

有道雲、石墨文檔 網址:https://note.youdao.com https://shimo.im

ProcessOn 、xmind 網址:www.processon.com www.xmind.cn

鳩摩搜索 網址:www.jiumodiary.com

腳本之家 網址:www.jb51.net/books

牛客網 校招 網址:www.nowcoder.com

LeetCode、lintcode 網址:https://leetcode-cn.com www.lintcode.com

數據結構模擬 網址:www.cs.usfca.edu

BOSS、拉鈎 網址:www.zhipin.com www.lagou.com

我相信上面的一下網站,總有一兩個是能幫助到大家的,學習是個時而欣喜若狂,時而鬱郁寡歡的道路,希望你能堅持下去,時間會回報你的。

我是敖丙,一個在互聯網苟且偷生的程序員。

你知道的越多,你不知道的越多,人才們的 【三連】 就是丙丙創作的最大動力,我們下期見!

注:如果本篇博客有任何錯誤和建議,歡迎人才們留言!

文章持續更新,可以微信搜索「 敖丙 」第一時間閱讀,回復【資料】有我準備的一線大廠面試資料和簡歷模板,本文 GitHub https://github.com/JavaFamily 已經收錄,有大廠面試完整考點,歡迎Star。

你知道的越多,你不知道的越多

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

日本、大陸,發現這些先進的國家已經早就讓電動車優先上路,而且先進國家空氣品質相當好,電動車節能減碳可以減少空污

Golang基礎教程——map使用篇_包裝設計

※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

網動廣告出品的網頁設計,採用精簡與質感的CSS語法,提升企業的專業形象與簡約舒適的瀏覽體驗,讓瀏覽者第一眼就愛上她。

本文始發於個人公眾號:TechFlow,原創不易,求個關注

今天是golang專題的第7篇文章,我們來聊聊golang當中map的用法。

map這個數據結構我們經常使用,存儲的是key-value的鍵值對。在C++/java當中叫做map,在Python中叫做dict。這些數據結構的名稱雖然不經相同,背後的技術支撐也不一定一樣,比如說C++的map是紅黑樹實現的,Java中的hashmap則是通過hash表。但是使用起來的方法都差不多,除了Java是通過get方法獲取鍵值之外,C++、Python和golang都是通過方括號獲取的。

聲明與初始化

golang中的map聲明非常簡單,我們用map關鍵字表示聲明一個map,然後在方括號內填上key的類型,方括號外填上value的類型。

var m map[string] int

這樣我們就聲明好了一個map。

但是要注意,這樣聲明得到的是一個空的map,map的零值是nil,可以理解成空指針。所以我們不能直接去操作這個m,否則會得到一個panic。

panic: assignment to entry in nil map

panic在golang當中表示非常嚴重不可恢復的錯誤,可以恢復的錯誤有些類似於Java或者是其他語言當中的異常,當異常出現的時候,我們可以選擇handle住它們,讓程序不崩潰繼續運行。而那些非常嚴重,無法handle的異常在golang當中稱為panic。

golang當中的異常處理機制和其他語言相差很大,整體的邏輯和內核都不太一樣。當然這個是一個比較大的話題,我們這裏可以簡單將它理解成error就行了。

回到map上來,我們聲明了一個map之後,想要使用它還需要對它進行初始化。使用它的方法也很簡單,就是使用make方法創建出一個實例來。它的用法和之前通過make創建元組非常類似:

m = make(map[string] int)

// 我們還可以指定創建出來的map的存儲能力的大小
m = make(map[string] int, 100)

我們也可以在聲明的時候把初始化也寫上:

var m = map[string] int {"abc": 3, "ccd": 4}

當然也可以通過賦值運算符,直接make出一個空的map來:

m := make(map[string] int)

增刪改查

map創建好了當然是要用的,整體使用起來和Python當中的dict比較像,比較簡單直觀,沒有太多彎彎繞的東西。我們一個一個來看,首先是map的添加元素。map的添加元素直接用方括號賦值即可:

※南投搬家公司費用需注意的眉眉角角,別等搬了再說!

上新台中搬家公司提供您一套專業有效率且人性化的辦公室搬遷、公司行號搬家及工廠遷廠的搬家服務

m["abc"] = 4

同樣,我們需要保證這裏的m經過初始化,否則也會包nil的panic。如果key值在map當中已經存在,那麼會自動替換掉原本的key。也就是說map的更新和添加元素都是一樣的,都是通過這種方式。如果不存在就是添加,否則則是更新。

刪除元素也很簡單,和Python當中類似,通過delete關鍵字刪除。

delete(m, "abc")

當我們刪除key的時候,如果是其他的語言,我們需要判斷這個key值是否存在,否則的話不能刪除,或者是會引起異常。在golang當中並不會,對這點做了優化。如果要刪除的key值原本就不在map當中,那麼當我們調用了delete之後,什麼也不會發生。但是有一點,必須要保證傳入的map不為nil,否則也會引起panic。

最後,我們看下元素的查找。對於Java和Python來說我們都是通過一些判斷語句來進行判斷的,比如java的話是containsKey,Python的話用in操作符。在golang當中我們則是直接通過方括號進行查詢,那麼這就有了一個問題,如果key不在其中怎麼辦?

如果是其他語言,我們直接訪問一個不存在的key是會拋出異常的,但是在golang當中不會觸發panic,因為它會額外返回一個bool類型的元素表示元素是否查找到。所以我們可以同時用兩個變量去接收,如果第二個變量為True的話,就說明查找成功了。

進一步,我們還可以將這個邏輯和if的初始化操作合在一起:

if val, ok := m["1234"]; ok {
    fmt.Println(val)
}

這裏的ok就表示查找是否成功,這也是golang當中map查找的慣用寫法。

最後, 我們看一個實際運用map的例子,通過map來生成統計字符串當中單詞數量的wordCount:

package main

import (
 "golang.org/x/tour/wc"
 "strings"
)

func WordCount(s string) map[string]int {
 cnt := make(map[string]int)
    // 通過Split方法拆分字符串
 for _, str:= range strings.Split(s){
        // 直接++即可,golang會自動填充
  cnt[str]++
 }
 return cnt
}

func main() {
 wc.Test(WordCount)
}

總結

到這裏,關於golang當中map的使用就算是介紹完了。我們可以發現,map一如既往地體現了golang語法精簡的特點。比如通過返回error的操作省略了判斷元素是否存在map當中的操作,剛開始的時候會覺得有些不太適應,但是接觸多了之後,會發現這些都是有套路的。golang的套路就是精簡,能省就省,能簡單絕不複雜。

這一點不僅在map上體現,在其他特性上也是一樣。在後續的內容當中,我們還會繼續感知這一點。

如果喜歡本文,可以的話,請點個關注,給我一點鼓勵,也方便獲取更多文章。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※產品缺大量曝光嗎?你需要的是一流包裝設計!

窩窩觸角包含自媒體、自有平台及其他國家營銷業務等,多角化經營並具有國際觀的永續理念。

用TensorFlow搭建一個萬能的神經網絡框架(持續更新),tensorflow常用函數_台中搬家

※台中搬家公司費用怎麼算?

擁有20年純熟搬遷經驗,提供免費估價且流程透明更是5星評價的搬家公司

博客作者:凌逆戰

博客地址:https://www.cnblogs.com/LXP-Never/p/12774058.html

文章代碼:https://github.com/LXP-Never/blog_data/tree/master/tensorflow_model

  我一直覺得TensorFlow的深度神經網絡代碼非常困難且繁瑣,對TensorFlow搭建模型也十分困惑,所以我近期閱讀了大量的神經網絡代碼,終於找到了搭建神經網絡的規律,各位要是覺得我的文章對你有幫助不妨點個贊,點個關注吧。

  我個人把深度學習分為以下步驟:數據處理 –> 模型搭建 –> 構建損失 –> 模型訓練 –> 模型評估

我先把代碼放出來,然後一點一點來講

# Author:凌逆戰
# -*- encoding:utf-8 -*-
# 修改時間:2020年5月31日
import time
from tensorflow.examples.tutorials.mnist import input_data
from nets.my_alex import alexNet
from ops import *

tf.flags.DEFINE_integer('batch_size', 50, 'batch size, default: 1')
tf.flags.DEFINE_integer('class_num', 10, 'batch size, default: 1')
tf.flags.DEFINE_integer('epochs', 10, 'batch size, default: 1')
tf.flags.DEFINE_float('learning_rate', 1e-4, '初始學習率, 默認: 0.0002')
tf.flags.DEFINE_string('checkpoints_dir', "checkpoints", '保存檢查點的地址')
FLAGS = tf.flags.FLAGS

# 從MNIST_data/中讀取MNIST數據。當數據不存在時,會自動執行下載
mnist = input_data.read_data_sets('./data', one_hot=True, reshape=False)
# reshape=False  (None, 28,28,1)    # 用於第一層是卷積層
# reshape=False  (None, 784)        # 用於第一層是全連接層

# 我們看一下數據的shape
print(mnist.train.images.shape)  # 訓練數據圖片(55000, 28, 28, 1)
print(mnist.train.labels.shape)  # 訓練數據標籤(55000, 10)
print(mnist.test.images.shape)  # 測試數據圖片(10000, 28, 28, 1)
print(mnist.test.labels.shape)  # 測試數據圖片(10000, 10)
print(mnist.validation.images.shape)  # 驗證數據圖片(5000, 28, 28, 1)
print(mnist.validation.labels.shape)  # 驗證數據圖片(5000, 784)


def train():
    batch_size = FLAGS.batch_size  # 一個batch訓練多少個樣本
    batch_nums = mnist.train.images.shape[0] // batch_size  # 一個epoch中應該包含多少batch數據
    class_num = FLAGS.class_num  # 分類類別數
    epochs = FLAGS.epochs  # 訓練周期數
    learning_rate = FLAGS.learning_rate  # 初始學習率

    ############    保存檢查點的地址   ############
    checkpoints_dir = FLAGS.checkpoints_dir  # checkpoints
    # 如果檢查點不存在,則創建
    if not os.path.exists(checkpoints_dir):
        os.makedirs(FLAGS.checkpoints_dir)

    ######################################################
    #                    創建圖                          #
    ######################################################
    graph = tf.Graph()  # 自定義圖
    # 在自己的圖中定義數據和操作
    with graph.as_default():
        inputs = tf.placeholder(dtype="float", shape=[None, 28, 28, 1], name='inputs')
        labels = tf.placeholder(dtype="float", shape=[None, class_num], name='labels')
        # 看個人喜歡,有的人在初始化定義中就定義了learning_rate,有的人喜歡通過feed傳learning_rate
        learning_rate = tf.placeholder("float", None, name='learning_rate')
        # 如果網絡結構有dropout層,需要定義keep_probn,如果沒有則不需要
        # 訓練的時候需要,測試的時候需要設置成1
        keep_prob = tf.placeholder(dtype="float", name='keep_prob')
        ############    搭建模型   ############
        logits = alexNet(inputs, class_num, keep_prob=keep_prob)  # 使用placeholder搭建模型
        ############    損失函數   ############
        loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits(labels=labels, logits=logits))
        tf.add_to_collection('losses', loss)
        total_loss = tf.add_n(tf.get_collection("losses"))  # total_loss=模型損失+權重正則化損失
        ############    模型精度   ############
        predict = tf.argmax(logits, 1)  # 模型預測結果
        accuracy = tf.reduce_mean(tf.cast(tf.equal(predict, tf.argmax(labels, 1)), tf.float32))
        ############    優化器   ############
        variable_to_train = tf.get_collection(tf.GraphKeys.TRAINABLE_VARIABLES)  # 可訓練變量列表
        # 創建優化器,更新網絡參數,最小化loss,
        global_step = tf.Variable(0, trainable=False)
        learning_rate = tf.train.exponential_decay(learning_rate=learning_rate,  # 初始學習率
                                                   global_step=global_step,
                                                   decay_steps=batch_nums,  # 多少步衰減一次
                                                   decay_rate=0.1,  # 衰減率
                                                   staircase=True)  # 以階梯的形式衰減
        # 移動平均值更新參數
        # train_op = moving_average(loss, learning_rate, global_step)
        # adam優化器,adam算法好像會自動衰減學習率,
        train_op = tf.train.AdamOptimizer(learning_rate).minimize(loss=total_loss,
                                                                  global_step=global_step,
                                                                  var_list=variable_to_train)
        ############    TensorBoard可視化 summary  ############
        summary_writer = tf.summary.FileWriter(logdir="./logs", graph=graph)  # 創建事件文件
        tf.summary.scalar(name="losses", tensor=total_loss)  # 收集損失值變量
        tf.summary.scalar(name="acc", tensor=accuracy)  # 收集精度值變量
        tf.summary.scalar(name='learning_rate', tensor=learning_rate)
        merged_summary_op = tf.summary.merge_all()  # 將所有的summary合併為一個op
        ############    模型保存和恢復 Saver   ############
        saver = tf.train.Saver(max_to_keep=5)

    ######################################################
    #                   創建會話                          #
    ######################################################
    max_acc = 0.
    config = tf.ConfigProto(allow_soft_placement=True, log_device_placement=True)
    with tf.Session(config=config, graph=graph) as sess:
        # 加載模型,如果模型存在返回 是否加載成功和訓練步數
        could_load, checkpoint_step = load_model(sess, saver, FLAGS.checkpoints_dir)
        if could_load:
            print(" [*] 模型加載成功")
        else:
            print(" [!] 模型加載失敗")
            try:
                tf.global_variables_initializer().run()
            except:
                tf.initialize_all_variables().run()

        for epoch in range(epochs):
            for i in range(batch_nums):
                start_time = time.time()
                # batch_images = data_X[i * batch_size:(i + 1) * batch_size]
                # batch_labels = data_y[i * batch_size:(i + 1) * batch_size]
                train_batch_x, train_batch_y = mnist.train.next_batch(batch_size)

                # 使用真實數據填充placeholder,運行訓練模型和合併變量操作
                _, summary, loss, step = sess.run([train_op, merged_summary_op, total_loss, global_step],
                                                  feed_dict={inputs: train_batch_x,
                                                             labels: train_batch_y,
                                                             keep_prob: 0.5})
                if step % 100 == 0:
                    summary_writer.add_summary(summary, step)  # 將每次迭代后的變量寫入事件文件
                    summary_writer.flush()  # 強制summary_writer將緩存中的數據寫入到日誌文件中(可選)

                    ############    可視化打印   ############
                    print("Epoch:[%2d] [%4d/%4d] time:%4.4f,loss:%.8f" % (
                        epoch, i, batch_nums, time.time() - start_time, loss))

                # 打印一些可視化的數據,損失...
                if step % 100 == 0:
                    acc = sess.run(accuracy, feed_dict={inputs: mnist.validation.images,
                                                        labels: mnist.validation.labels,
                                                        keep_prob: 1.0})
                    print("Epoch:[%2d] [%4d/%4d] accuracy:%.8f" % (epoch, i, batch_nums, acc))
                    ############    保存模型   ############
                    if acc > max_acc:
                        max_acc = acc
                        save_path = saver.save(sess,
                                               save_path=os.path.join(checkpoints_dir, "model.ckpt"),
                                               global_step=step)
                        tf.logging.info("模型保存在: %s" % save_path)
        print("優化完成!")


def main(argv=None):
    train()


if __name__ == '__main__':
    # logging.basicConfig(level=logging.INFO)
    tf.logging.set_verbosity(tf.logging.INFO)
    tf.app.run()

main(global_step)

# Author:凌逆戰
# -*- encoding:utf-8 -*-
# 修改時間:2020年5月31日
import time
from tensorflow.examples.tutorials.mnist import input_data
from nets.my_vgg import VGG16Net
from ops import *

tf.flags.DEFINE_integer('batch_size', 100, 'batch size, default: 1')
tf.flags.DEFINE_integer('class_num', 10, 'batch size, default: 1')
tf.flags.DEFINE_integer('epochs', 10, 'batch size, default: 1')
tf.flags.DEFINE_float('learning_rate', 2e-4, '初始學習率, 默認: 0.0001')
tf.flags.DEFINE_string('checkpoints_dir', "checkpoint", '保存檢查點的地址')
FLAGS = tf.flags.FLAGS

# 從MNIST_data/中讀取MNIST數據。當數據不存在時,會自動執行下載
mnist = input_data.read_data_sets('./MNIST_data', one_hot=True, reshape=False)
# reshape=False  (None, 28,28,1)    # 用於第一層是卷積層
# reshape=False  (None, 784)        # 用於第一層是全連接層

# 我們看一下數據的shape
print(mnist.train.images.shape)  # 訓練數據圖片(55000, 28, 28, 1)
print(mnist.train.labels.shape)  # 訓練數據標籤(55000, 10)
print(mnist.test.images.shape)  # 測試數據圖片(10000, 28, 28, 1)
print(mnist.test.labels.shape)  # 測試數據圖片(10000, 10)
print(mnist.validation.images.shape)  # 驗證數據圖片(5000, 28, 28, 1)
print(mnist.validation.labels.shape)  # 驗證數據圖片(5000, 784)


def train():
    batch_size = FLAGS.batch_size
    batch_nums = mnist.train.images.shape[0] // batch_size  # 一個epoch中應該包含多少batch數據
    class_num = FLAGS.class_num
    epochs = FLAGS.epochs
    learning_rate = FLAGS.learning_rate

    ############    保存檢查點的地址   ############
    checkpoints_dir = FLAGS.checkpoints_dir  # checkpoints
    # 如果檢查點不存在,則創建
    if not os.path.exists(checkpoints_dir):
        os.makedirs(FLAGS.checkpoints_dir)

    ######################################################
    #                    創建圖                          #
    ######################################################
    graph = tf.Graph()  # 自定義圖
    # 在自己的圖中定義數據和操作
    with graph.as_default():
        inputs = tf.placeholder(dtype="float", shape=[None, 28, 28, 1], name='inputs')
        labels = tf.placeholder(dtype="float", shape=[None, class_num], name='labels')
        ############    搭建模型   ############
        logits = VGG16Net(inputs, class_num)  # 使用placeholder搭建模型
        ############    損失函數   ############
        # 計算預測值和真實值之間的誤差
        loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits(labels=labels, logits=logits))
        tf.add_to_collection('losses', loss)
        total_loss = tf.add_n(tf.get_collection("losses"))  # total_loss=模型損失+權重正則化損失
        ############    模型精度   ############
        predict = tf.argmax(logits, axis=1)
        accuracy = tf.reduce_mean(tf.cast(tf.equal(predict, tf.argmax(labels, axis=1)), tf.float32))
        ############    優化器   ############
        variable_to_train = tf.get_collection(tf.GraphKeys.TRAINABLE_VARIABLES)  # 可訓練變量列表
        # 創建優化器,更新網絡參數,最小化loss,
        train_op = tf.train.AdamOptimizer(learning_rate).minimize(loss=total_loss,
                                                                  var_list=variable_to_train)
        ############    TensorBoard可視化 summary  ############
        summary_writer = tf.summary.FileWriter("./logs", graph=graph)  # 創建事件文件
        tf.summary.scalar(name="loss", tensor=total_loss)  # 收集損失值變量
        tf.summary.scalar(name='accuracy', tensor=accuracy)  # 收集精度值變量
        tf.summary.scalar(name='learning_rate', tensor=learning_rate)
        merged_summary_op = tf.summary.merge_all()  # 將所有的summary合併為一個op
        ############    模型保存和恢復 Saver   ############
        saver = tf.train.Saver(max_to_keep=5)

    ######################################################
    #                   創建會話                          #
    ######################################################
    max_acc = 0.
    config = tf.ConfigProto(allow_soft_placement=True, log_device_placement=True)
    with tf.Session(config=config, graph=graph) as sess:
        # 加載模型,如果模型存在返回 是否加載成功和訓練步數
        could_load, checkpoint_step = load_model(sess, saver, FLAGS.checkpoints_dir)
        if could_load:
            step = checkpoint_step
            print(" [*] 模型加載成功")
        else:
            print(" [!] 模型加載失敗")
            try:
                tf.global_variables_initializer().run()
            except:
                tf.initialize_all_variables().run()
            step = 0

        for epoch in range(epochs):
            for i in range(batch_nums):
                start_time = time.time()    # 記錄一下開始訓練的時間
                # batch_images = data_X[i * batch_size:(i + 1) * batch_size]
                # batch_labels = data_y[i * batch_size:(i + 1) * batch_size]
                train_batch_x, train_batch_y = mnist.train.next_batch(batch_size)

                # 使用真實數據填充placeholder,運行訓練模型和合併變量操作
                _, summary, loss = sess.run([train_op, merged_summary_op, total_loss],
                                            feed_dict={inputs: train_batch_x,
                                                       labels: train_batch_y})
                if step % 100 == 0:
                    summary_writer.add_summary(summary, step)  # 將每次迭代后的變量寫入事件文件
                    summary_writer.flush()  # 強制summary_writer將緩存中的數據寫入到日誌文件中(可選)

                ############    可視化打印   ############
                print("Epoch:[%2d] [%4d/%4d] time:%4.4f,loss:%.8f" % (
                    epoch, i, batch_nums, time.time() - start_time, loss))

                # 打印一些可視化的數據,損失...
                # if np.mod(step, 100) == 1
                if step % 100 == 0:
                    acc = sess.run(accuracy, {inputs: mnist.validation.images,
                                              labels: mnist.validation.labels})
                    print("Epoch:[%2d] [%4d/%4d],acc:%.8f" % (epoch, i, batch_nums, acc))
                    ############    保存模型   ############
                    if acc > max_acc:
                        max_acc = acc
                        save_path = saver.save(sess,
                                               save_path=os.path.join(checkpoints_dir, "model.ckpt"),
                                               global_step=step)
                        # logging.info("模型保存在: %s" % save_path)
                        tf.logging.info("模型保存在: %s" % save_path)
                step += 1
            print("優化完成!")


def main(argv=None):
    train()


if __name__ == '__main__':
    # logging.basicConfig(level=logging.INFO)
    tf.logging.set_verbosity(tf.logging.INFO)
    tf.app.run()

main(step)

數據處理

  數據處理因為每個專業領域的原因各不相同,而這不同點也是各位論文創新點的新方向。不同的我沒法講,但我總結了幾點相同的地方——batch數據生成。因為深度學習模型需要一個batch一個batch的喂數據進行訓練,所以我們的數據必須是batch的形式,這裏衍生了三點問題

  1. 通過代碼批量讀取數據,
  2. 如何生成batch數據:由於篇幅過長,實在有很多地方要介紹和詳述,我把這一塊內容移到了這篇文章《TensorFlow讀取數據的三種方法》中
  3. 數據的shape:我舉兩個例子讓大家理解:圖片數據為4維 (batch_size, height,width, channels),序列數據為3維 (batch_size, time_steps, input_size),
    • 不同的shape處理方法不同,選擇神經網絡模型單元也不同。我會在後面細講

模型搭建

  閱讀這一節我默認大家已經學會了數據的batch讀取了。

  模型搭建這一步很像我們小時候玩的搭積木,我這裏以經典神經網絡模型VGG、Alex、ResNet、Google Inception Net為例講解,大家看代碼看多了也會很簡單的就找到,當然我是有一點私心的,我想把這些經典的網絡在這篇文章做一個tensorflow實現匯總,我細講第一個,大家可能看一個例子就懂了,看懂了就直接往下看,看不懂就多看幾個。

LeNet5模型

論文:1998_LeNet_Gradient-Based Learning Applied to Document Recognition

  下面我們定義一個LeNet5模型,我們先定義需要用到的神經網絡單元,相同的代碼盡量封裝成函數的形式以節省代碼量和簡潔代碼

def conv(input, kernel_size, output_size, stride, init_bias=0.0, padding="SAME", name=None, wd=None):
    input_size = input.shape[-1]
    conv_weights = tf.get_variable(name='weights',
                                   shape=[kernel_size, kernel_size, input_size, output_size],
                                   initializer=tf.truncated_normal_initializer(stddev=0.1),
                                   dtype=tf.float32)
    conv_biases = tf.get_variable(name='biases',
                                  shape=[output_size],
                                  initializer=tf.constant_initializer(init_bias),
                                  dtype=tf.float32)

    if wd is not None:
        # wd 0.004
        # tf.nn.l2_loss(var)=sum(t**2)/2
        weight_decay = tf.multiply(tf.nn.l2_loss(conv_weights), wd, name='weight_loss')
        tf.add_to_collection('losses', weight_decay)

    conv_layer = tf.nn.conv2d(input, conv_weights, [1, stride, stride, 1], padding=padding, name=name)  # 卷積操作
    conv_layer = tf.nn.bias_add(conv_layer, conv_biases)  # 加上偏置項
    conv_layer = tf.nn.relu(conv_layer)  # relu激活函數

    return conv_layer


def fc(input, output_size, init_bias=0.0, activeation_func=True, wd=None):
    input_shape = input.get_shape().as_list()
    # 創建 全連接權重 變量
    fc_weights = tf.get_variable(name="weights",
                                 shape=[input_shape[-1], output_size],
                                 initializer=tf.truncated_normal_initializer(stddev=0.1),
                                 dtype=tf.float32)
    if wd is not None:
        # wd 0.004
        # tf.nn.l2_loss(var)=sum(t**2)/2
        weight_decay = tf.multiply(tf.nn.l2_loss(fc_weights), wd, name='weight_loss')
        tf.add_to_collection('losses', weight_decay)
    # 創建 全連接偏置 變量
    fc_biases = tf.get_variable(name="biases",
                                shape=[output_size],
                                initializer=tf.constant_initializer(init_bias),
                                dtype=tf.float32)

    fc_layer = tf.matmul(input, fc_weights)  # 全連接計算
    fc_layer = tf.nn.bias_add(fc_layer, fc_biases)  # 加上偏置項
    if activeation_func:
        fc_layer = tf.nn.relu(fc_layer)  # rele激活函數
    return fc_layer

View Code

  然後利用我們搭建的神經網絡單元,搭建LeNet5神經網絡模型

# 訓練時:keep_prob=0.5
# 測試時:keep_prob=1.0
def leNet(inputs, class_num, keep_prob=0.5):
    # 第一層 卷積層 conv1
    with tf.variable_scope('layer1-conv1'):
        conv1 = conv(input=inputs, kernel_size=5, output_size=32, stride=1, init_bias=0.0, name="layer1-conv1",
                     padding="SAME")
    # 第二層 池化層
    with tf.name_scope('layer2-pool1'):
        pool1 = tf.nn.max_pool(conv1, ksize=[1, 2, 2, 1], strides=[1, 2, 2, 1], padding='SAME')
    # 第三層 卷積層 conv2
    with tf.variable_scope('layer3-conv2'):
        conv2 = conv(input=pool1, kernel_size=5, output_size=64, stride=1, init_bias=0.0, name="layer3-conv2",
                     padding="SAME")
    # 第四層 池化層
    with tf.name_scope('layer4-pool2'):
        pool2 = tf.nn.max_pool(conv2, ksize=[1, 2, 2, 1], strides=[1, 2, 2, 1], padding='SAME')

    # 後面要做全連接,因此要把數據變成2維
    # pool_shape = pool2.get_shape().as_list()
    pool_shape = pool2.shape
    flatten = tf.reshape(pool2, [-1, pool_shape[1] * pool_shape[2] * pool_shape[3]])
    with tf.variable_scope('layer5-fcl'):
        fc1 = fc(input=flatten, output_size=512, init_bias=0.1, activeation_func=tf.nn.relu, wd=None)
        fc1 = tf.nn.dropout(fc1, keep_prob=keep_prob, name="dropout1")
    with tf.variable_scope('layer6-fc2'):
        logit = fc(input=fc1, output_size=class_num, init_bias=0.1, activeation_func=False, wd=None)
    return logit

Alex模型

論文:2012_Alex_ImageNet Classification with Deep Convolutional Neural Networks

  下面我們定義一個Alex模型,我們先定義需要用到的神經網絡單元,相同的代碼盡量封裝成函數的形式以節省代碼量和簡潔代碼

def conv(input, kernel_size, output_size, stride, init_bias=0.0, padding="SAME", name=None, wd=None):
    input_size = input.shape[-1]
    conv_weights = tf.get_variable(name='weights',
                                   shape=[kernel_size, kernel_size, input_size, output_size],
                                   initializer=tf.random_normal_initializer(mean=0, stddev=0.01),
                                   dtype=tf.float32)
    if wd is not None:
        # wd 0.004
        # tf.nn.l2_loss(var)=sum(t**2)/2
        weight_decay = tf.multiply(tf.nn.l2_loss(conv_weights), wd, name='weight_loss')
        tf.add_to_collection('losses', weight_decay)

    conv_biases = tf.get_variable(name='biases',
                                  shape=[output_size],
                                  initializer=tf.constant_initializer(init_bias),
                                  dtype=tf.float32)
    conv_layer = tf.nn.conv2d(input, conv_weights, [1, stride, stride, 1], padding=padding, name=name)  # 卷積操作
    conv_layer = tf.nn.bias_add(conv_layer, conv_biases)  # 加上偏置項
    conv_layer = tf.nn.relu(conv_layer)  # relu激活函數

    return conv_layer

conv函數

def fc(input, output_size, init_bias=0.0, activeation_func=True, wd=None):
    input_shape = input.get_shape().as_list()
    # 創建 全連接權重 變量
    fc_weights = tf.get_variable(name="weights",
                                 shape=[input_shape[-1], output_size],
                                 initializer=tf.random_normal_initializer(mean=0.0, stddev=0.01),
                                 dtype=tf.float32)
    if wd is not None:
        # wd 0.004
        # tf.nn.l2_loss(var)=sum(t**2)/2
        weight_decay = tf.multiply(tf.nn.l2_loss(fc_weights), wd, name='weight_loss')
        tf.add_to_collection('losses', weight_decay)

    # 創建 全連接偏置 變量
    fc_biases = tf.get_variable(name="biases",
                                shape=[output_size],
                                initializer=tf.constant_initializer(init_bias),
                                dtype=tf.float32)

    fc_layer = tf.matmul(input, fc_weights)  # 全連接計算
    fc_layer = tf.nn.bias_add(fc_layer, fc_biases)  # 加上偏置項
    if activeation_func:
        fc_layer = tf.nn.relu(fc_layer)  # rele激活函數
    return fc_layer

fc函數

def LRN(input, depth_radius=2, alpha=0.0001, beta=0.75, bias=1.0):
    """Local Response Normalization 局部響應歸一化"""
    return tf.nn.local_response_normalization(input, depth_radius=depth_radius, alpha=alpha,
                                              beta=beta, bias=bias)

LRN函數

  然後利用我們搭建的神經網絡單元,搭建Alex神經網絡模型

def alexNet(inputs, class_num, keep_prob=0.5):
    # 第一層卷積層 conv1
    with tf.variable_scope("conv1"):
        conv1 = conv(input=inputs, kernel_size=7, output_size=96, stride=3, init_bias=0.0, name="conv1", padding="SAME")
        conv1 = LRN(conv1)
        conv1 = tf.nn.max_pool(conv1, ksize=[1, 3, 3, 1], strides=[1, 2, 2, 1], padding='VALID', name="pool1")
    # 第二層卷積層 conv2
    with tf.variable_scope("conv2"):
        conv2 = conv(input=conv1, kernel_size=7, output_size=96, stride=3, init_bias=1.0, name="conv2", padding="SAME")
        conv2 = LRN(conv2)
        conv2 = tf.nn.max_pool(conv2, ksize=[1, 3, 3, 1], strides=[1, 2, 2, 1], padding='VALID', name="pool2")
    # 第三層卷積層 conv3
    with tf.variable_scope("conv3"):
        conv3 = conv(input=conv2, kernel_size=7, output_size=96, stride=3, init_bias=0.0, name="conv3", padding="SAME")
    # 第四層卷積層 conv4
    with tf.variable_scope("conv4"):
        conv4 = conv(input=conv3, kernel_size=7, output_size=96, stride=3, init_bias=1.0, name="conv4", padding="SAME")
    # 第五層卷積層 conv5
    with tf.variable_scope("conv5"):
        conv5 = conv(input=conv4, kernel_size=3, output_size=256, stride=1, init_bias=1.0, name="conv5")
        conv5 = tf.nn.max_pool(conv5, ksize=[1, 3, 3, 1], strides=[1, 2, 2, 1], padding='VALID', name="pool5")
    conv5_shape = conv5.shape  # 後面做全連接,所以要把shape改成2維
    # shape=[batch, dim]
    flatten = tf.reshape(conv5, [-1, conv5_shape[1] * conv5_shape[2] * conv5_shape[3]])
    # 第一層全連接層 fc1
    with tf.variable_scope("fc1"):
        fc1 = fc(input=flatten, output_size=4096, init_bias=1.0, activeation_func=tf.nn.relu, wd=None)
        fc1 = tf.nn.dropout(fc1, keep_prob=keep_prob, name="dropout1")
    # 第一層全連接層 fc2
    with tf.variable_scope("fc2"):
        fc2 = fc(input=fc1, output_size=4096, init_bias=1.0, activeation_func=tf.nn.relu, wd=None)
        fc2 = tf.nn.dropout(fc2, keep_prob=keep_prob, name="dropout1")
    # 第一層全連接層 fc3
    with tf.variable_scope("fc3"):
        logit = fc(input=fc2, output_size=class_num, init_bias=1.0, activeation_func=False, wd=None)

    return logit  # 模型輸出

VGG模型

論文:2014_VGG_Very Deep Convolutional Networks for Large-Scale Image Recognition

VGG有兩個比較有名的網絡:VGG16、VGG19,我在這裏搭建VGG16,有興趣的朋友可以按照上面的模型結構自己用TensorFlow搭建VGG19模型

  下面我們定義一個VGG16模型,和前面一樣,我們先定義需要用到的神經網絡單元,相同的代碼盡量封裝成函數的形式以節省代碼量和簡潔代碼

  因為模型中同一個變量域中包含多個卷積操作,因此在卷積函數中套一層變量域

def conv(inputs, scope_name, kernel_size, output_size, stride, init_bias=0.0, padding="SAME", wd=None):
    input_size = int(inputs.get_shape()[-1])
    with tf.variable_scope(scope_name):
        conv_weights = tf.get_variable(name='weights',
                                       shape=[kernel_size, kernel_size, input_size, output_size],
                                       dtype=tf.float32,
                                       initializer=tf.truncated_normal_initializer(mean=0.0, stddev=1e-1))
        if wd is not None:
            # tf.nn.l2_loss(var)=sum(t**2)/2
            weight_decay = tf.multiply(tf.nn.l2_loss(conv_weights), wd, name='weight_loss')
            tf.add_to_collection('losses', weight_decay)

        conv_biases = tf.get_variable(name='biases',
                                      shape=[output_size],
                                      dtype=tf.float32,
                                      initializer=tf.constant_initializer(init_bias))
        conv_layer = tf.nn.conv2d(inputs, conv_weights, [1, stride, stride, 1], padding=padding, name=scope_name)
        conv_layer = tf.nn.bias_add(conv_layer, conv_biases)
        conv_layer = tf.nn.relu(conv_layer)
    return conv_layer

conv函數

def fc(inputs, scope_name, output_size, init_bias=0.0, activeation_func=True, wd=None):
    input_shape = inputs.get_shape().as_list()
    with tf.variable_scope(scope_name):
        # 創建 全連接權重 變量
        fc_weights = tf.get_variable(name="weights",
                                     shape=[input_shape[-1], output_size],
                                     dtype=tf.float32,
                                     initializer=tf.truncated_normal_initializer(mean=0.0, stddev=1e-1))
        if wd is not None:
            # wd 0.004
            # tf.nn.l2_loss(var)=sum(t**2)/2
            weight_decay = tf.multiply(tf.nn.l2_loss(fc_weights), wd, name='weight_loss')
            tf.add_to_collection('losses', weight_decay)
        
        # 創建 全連接偏置 變量
        fc_biases = tf.get_variable(name="biases",
                                    shape=[output_size],
                                    dtype=tf.float32,
                                    initializer=tf.constant_initializer(init_bias),
                                    trainable=True)

        fc_layer = tf.matmul(inputs, fc_weights)  # 全連接計算
        fc_layer = tf.nn.bias_add(fc_layer, fc_biases)  # 加上偏置項
        if activeation_func:
            fc_layer = tf.nn.relu(fc_layer)  # rele激活函數
    return fc_layer

fc函數

  然後利用我們搭建的神經網絡單元,搭建VGG16神經網絡模型

def VGG16Net(inputs, class_num):
    with tf.variable_scope("conv1"):
        # conv1_1 [conv3_64]
        conv1_1 = conv(inputs=inputs, scope_name="conv1_1", kernel_size=3, output_size=64, stride=1,
                       init_bias=0.0, padding="SAME")
        # conv1_2 [conv3_64]
        conv1_2 = conv(inputs=conv1_1, scope_name="conv1_2", kernel_size=3, output_size=64, stride=1,
                       init_bias=0.0, padding="SAME")
    pool1 = tf.nn.max_pool(conv1_2, ksize=[1, 2, 2, 1], strides=[1, 2, 2, 1], padding='SAME', name='pool1')
    with tf.variable_scope("conv2"):
        # conv2_1
        conv2_1 = conv(inputs=pool1, scope_name="conv2_1", kernel_size=3, output_size=128, stride=1,
                       init_bias=0.0, padding="SAME")
        # conv2_2
        conv2_2 = conv(inputs=conv2_1, scope_name="conv2_2", kernel_size=3, output_size=128, stride=1,
                       init_bias=0.0, padding="SAME")
    pool2 = tf.nn.max_pool(conv2_2, ksize=[1, 2, 2, 1], strides=[1, 2, 2, 1], padding='SAME', name='pool2')
    with tf.variable_scope("conv3"):
        # conv3_1
        conv3_1 = conv(inputs=pool2, scope_name="conv3_1", kernel_size=3, output_size=256, stride=1,
                       init_bias=0.0, padding="SAME")
        # conv3_2
        conv3_2 = conv(inputs=conv3_1, scope_name="conv3_2", kernel_size=3, output_size=256, stride=1,
                       init_bias=0.0, padding="SAME")
        # conv3_3
        conv3_3 = conv(inputs=conv3_2, scope_name="conv3_3", kernel_size=3, output_size=256, stride=1,
                       init_bias=0.0, padding="SAME")
    pool3 = tf.nn.max_pool(conv3_3, ksize=[1, 2, 2, 1], strides=[1, 2, 2, 1], padding='SAME', name='pool3')
    with tf.variable_scope("conv4"):
        # conv4_1
        conv4_1 = conv(inputs=pool3, scope_name="conv4_1", kernel_size=3, output_size=512, stride=1,
                       init_bias=0.0, padding="SAME")
        # conv4_2
        conv4_2 = conv(inputs=conv4_1, scope_name="conv4_2", kernel_size=3, output_size=512, stride=1,
                       init_bias=0.0, padding="SAME")
        # conv4_3
        conv4_3 = conv(inputs=conv4_2, scope_name="conv4_3", kernel_size=3, output_size=512, stride=1,
                       init_bias=0.0, padding="SAME")
    pool4 = tf.nn.max_pool(conv4_3, ksize=[1, 2, 2, 1], strides=[1, 2, 2, 1], padding='SAME', name='pool4')
    with tf.variable_scope("conv5"):
        # conv5_1
        conv5_1 = conv(inputs=pool4, scope_name="conv4_1", kernel_size=3, output_size=512, stride=1,
                       init_bias=0.0, padding="SAME")
        # conv5_2
        conv5_2 = conv(inputs=conv5_1, scope_name="conv4_2", kernel_size=3, output_size=512, stride=1,
                       init_bias=0.0, padding="SAME")
        # conv5_3
        conv5_3 = conv(inputs=conv5_2, scope_name="conv4_3", kernel_size=3, output_size=512, stride=1,
                       init_bias=0.0, padding="SAME")
    pool5 = tf.nn.max_pool(conv5_3, ksize=[1, 2, 2, 1], strides=[1, 2, 2, 1], padding='SAME', name='pool4')
    input_shape = pool5.get_shape().as_list()  # 後面做全連接,所以要把shape改成2維
    # shape=[batch, dim]
    flatten = tf.reshape(pool5, [-1, input_shape[1] * input_shape[2] * input_shape[3]])
    fc1 = fc(inputs=flatten, scope_name="fc1", output_size=4096, init_bias=1.0, activeation_func=True)
    fc2 = fc(inputs=fc1, scope_name="fc2", output_size=4096, init_bias=1.0, activeation_func=True)
    fc3 = fc(inputs=fc2, scope_name="fc3", output_size=class_num, init_bias=1.0, activeation_func=True)

    return fc3

上圖中有一個softmax層,我們也可以定義出來

class_num = 1000
# placeholder 定義
inputs = tf.placeholder(dtype="float", shape=[None, 28, 28, 3], name='inputs')
labels = tf.placeholder(dtype="float", shape=[None, class_num], name='labels')
learning_rate = tf.placeholder("float", None, name='learning_rate')

logits = VGG16Net(inputs)
probs = tf.nn.softmax(logits)

ResNet模型

論文:

  • 2016_ResNet_Deep Residual Learning for Image Recognition
  • 2016_ResNet_Identity Mappings in Deep Residual Networks

  ResNet的網絡結構如下圖所示

我們先定義需要用到的神經網絡單元

def batch_normalization(inputs, output_size):
    mean, variance = tf.nn.moments(inputs, axes=[0, 1, 2])  # 計算均值和方差
    beta = tf.get_variable('beta', output_size, tf.float32, initializer=tf.zeros_initializer)
    gamma = tf.get_variable('gamma', output_size, tf.float32, initializer=tf.ones_initializer)
    bn_layer = tf.nn.batch_normalization(inputs, mean, variance, beta, gamma, 0.001)

    return bn_layer

batch_normalization函數

def conv(input, kernel_size, output_size, stride, padding="SAME", wd=None):
    input_size = input.shape[-1]
    conv_weights = tf.get_variable(name='weights',
                                   shape=[kernel_size, kernel_size, input_size, output_size],
                                   dtype=tf.float32,
                                   initializer=tf.truncated_normal_initializer(mean=0.0, stddev=0.1),
                                   regularizer=tf.contrib.layers.l2_regularizer(0.00004)) # 正則損失衰減率0.000004

    conv_layer = tf.nn.conv2d(input, conv_weights, [1, stride, stride, 1], padding=padding)  # 卷積操作
    batch_norm = batch_normalization(conv_layer, output_size)
    conv_output = tf.nn.relu(batch_norm)  # relu激活函數
    return conv_output

conv函數

def fc(input, output_size, activeation_func=True):
    input_shape = input.shape[-1]
    # 創建 全連接權重 變量
    fc_weights = tf.get_variable(name="weights",
                                 shape=[input_shape, output_size],
                                 initializer=tf.truncated_normal_initializer(stddev=0.01),
                                 dtype=tf.float32,
                                 regularizer=tf.contrib.layers.l2_regularizer(0.01))
    # 創建 全連接偏置 變量
    fc_biases = tf.get_variable(name="biases",
                                shape=[output_size],
                                initializer=tf.zeros_initializer,
                                dtype=tf.float32)

    fc_layer = tf.matmul(input, fc_weights)  # 全連接計算
    fc_layer = tf.nn.bias_add(fc_layer, fc_biases)  # 加上偏置項
    if activeation_func:
        fc_layer = tf.nn.relu(fc_layer)  # rele激活函數
    return fc_layer

fc函數

def block(input, n, output_size, change_first_stride, bottleneck):
    if n == 0 and change_first_stride:
        stride = 2
    else:
        stride = 1
    if bottleneck:
        with tf.variable_scope('a'):
            conv_a = conv(input=input, kernel_size=1, output_size=output_size, stride=stride, padding="SAME")
            conv_a = batch_normalization(conv_a, output_size)
            conv_a = tf.nn.relu(conv_a)
        with tf.variable_scope('b'):
            conv_b = conv(input=conv_a, kernel_size=3, output_size=output_size, stride=1, padding="SAME")
            conv_b = batch_normalization(conv_b, output_size)
            conv_b = tf.nn.relu(conv_b)

        with tf.variable_scope('c'):
            conv_c = conv(input=conv_b, kernel_size=1, output_size=output_size * 4, stride=1, padding="SAME")
            output = batch_normalization(conv_c, output_size * 4)
    else:
        with tf.variable_scope('A'):
            conv_A = conv(input=input, kernel_size=3, output_size=output_size, stride=stride, padding="SAME")
            conv_A = batch_normalization(conv_A, output_size)
            conv_A = tf.nn.relu(conv_A)

        with tf.variable_scope('B'):
            conv_B = conv(input=conv_A, kernel_size=3, output_size=output_size, stride=1, padding="SAME")
            output = batch_normalization(conv_B, output_size)

    if input.shape == output.shape:
        with tf.variable_scope('shortcut'):
            shortcut = input  # shortcut
    else:
        with tf.variable_scope('shortcut'):
            shortcut = conv(input=input, kernel_size=1, output_size=output_size * 4, stride=1, padding="SAME")
            shortcut = batch_normalization(shortcut, output_size * 4)

    return tf.nn.relu(output + shortcut)

block函數

  然後我們定義神經網絡框架

def inference(inputs, class_num, num_blocks=[3, 4, 6, 3], bottleneck=True):
    # data[1, 224, 224, 3]

    # 我們嘗試搭建50層ResNet
    with tf.variable_scope('conv1'):
        conv1 = conv(input=inputs, kernel_size=7, output_size=64, stride=2, padding="SAME")
        conv1 = batch_normalization(inputs=conv1, output_size=64)
        conv1 = tf.nn.relu(conv1)

    with tf.variable_scope('conv2_x'):
        conv_output = tf.nn.max_pool(conv1, ksize=[1, 3, 3, 1], strides=[1, 2, 2, 1], padding='SAME')
        for n in range(num_blocks[0]):
            with tf.variable_scope('block%d' % (n + 1)):
                conv_output = block(conv_output, n, output_size=64, change_first_stride=False, bottleneck=bottleneck)

    with tf.variable_scope('conv3_x'):
        for n in range(num_blocks[1]):
            with tf.variable_scope('block%d' % (n + 1)):
                conv_output = block(conv_output, n, output_size=128, change_first_stride=True, bottleneck=bottleneck)

    with tf.variable_scope('conv4_x'):
        for n in range(num_blocks[2]):
            with tf.variable_scope('block%d' % (n + 1)):
                conv_output = block(conv_output, n, output_size=256, change_first_stride=True, bottleneck=bottleneck)

    with tf.variable_scope('conv5_x'):
        for n in range(num_blocks[3]):
            with tf.variable_scope('block%d' % (n + 1)):
                conv_output = block(conv_output, n, output_size=512, change_first_stride=True, bottleneck=bottleneck)

    output = tf.reduce_mean(conv_output, reduction_indices=[1, 2], name="avg_pool")
    with tf.variable_scope('fc'):
        output = fc(output, class_num, activeation_func=False)

    return output

Google Inception Net模型

  Inception Net模型 以後再更新吧,如果這篇文章對大家有用,歡迎大家催促我。

RNN模型

  Tensorflow中的CNN變數很少,而RNN卻豐富多彩,不僅在RNN Cell上有很多種、在實現上也有很多種,在用法上更是花樣百出。

五個基本的RNN Cell:RNNCell、BasicRNNCell、LSTMCell、BasicLSTMCell、GRUCell

RNN Cell的封裝和變形:MultiRNNCell(多層RNN)、DropoutWrapper、ResidualWrapper、DeviceWrapper

四種架構 (static+dynamic)*(單向+雙向)=4:static_rnn(靜態RNN)、dynamic_rnn(動態RNN)、static_bidirectional_rnn(靜態雙向RNN)、bidirectional_dynamic_rnn(動態雙向RNN)

五種手法 (one+many)*(one+many) +1=5:

  1. one to one(1 vs 1):輸入一個,輸出一個。其實和全連接神經網絡並沒有什麼區別,這一類別算不得是 RNN。
  2. one to many(1 vs N):輸入一個,輸出多個。圖像標註,輸入一個圖片,得到對圖片的語言描述
  3. many to one(N vs 1):輸入多個,輸出一個。序列分類,把序列壓縮成一個向量
  4. many to many(N vs N):輸入多個,輸出多個。兩者長度可以不一樣。翻譯任務
  5. many to many(N vs N):輸入多個,輸出多個。兩者長度一樣。char RNN

我們先定義需要用到的神經網絡單元

全連接層

def fc(input, output_size, activeation_func=tf.nn.relu):
    input_shape = input.shape[-1]
    # 創建 全連接權重 變量
    fc_weights = tf.get_variable(name="weights",
                                 shape=[input_shape, output_size],
                                 initializer=tf.truncated_normal_initializer(stddev=0.01),
                                 dtype=tf.float32,
                                 regularizer=tf.contrib.layers.l2_regularizer(0.01))
    # 創建 全連接偏置 變量
    fc_biases = tf.get_variable(name="biases",
                                shape=[output_size],
                                initializer=tf.zeros_initializer,
                                dtype=tf.float32)

    fc_layer = tf.matmul(input, fc_weights)  # 全連接計算
    fc_layer = tf.nn.bias_add(fc_layer, fc_biases)  # 加上偏置項
    if activeation_func:
        fc_layer = activeation_func(fc_layer)  # rele激活函數
    return fc_layer

View Code

單層 靜態/動態 LSTM/GRU

#######################################
#       單層 靜態/動態 LSTM/GRU        #
#######################################
# 單層靜態LSTM
def single_layer_static_lstm(input_x, time_steps, hidden_size):
    """
    :param input_x: 輸入張量 形狀為[batch_size, n_steps, input_size]
    :param n_steps: 時序總數
    :param n_hidden: LSTM單元輸出的節點個數 即隱藏層節點數
    """
    # 把輸入input_x按列拆分,並返回一個有n_steps個張量組成的list
    # 如batch_sizex28x28的輸入拆成[(batch_size,28),((batch_size,28))....]
    # 如果是調用的是靜態rnn函數,需要這一步處理   即相當於把序列作為第一維度
    input_x1 = tf.unstack(input_x, num=time_steps, axis=1)
    lstm_cell = tf.nn.rnn_cell.BasicLSTMCell(num_units=hidden_size)  # 創建LSTM_cell
    # 靜態rnn函數傳入的是一個張量list  每一個元素都是一個(batch_size,input_size)大小的張量
    output, states = tf.nn.static_rnn(cell=lstm_cell, inputs=input_x1, dtype=tf.float32)  # 通過cell類構建RNN

    return output, states


# 單層靜態gru
def single_layer_static_gru(input, time_steps, hidden_size):
    """
    :param input: 輸入張量 形狀為[batch_size, n_steps, input_size]
    :param n_steps: 時序總數
    :param n_hidden: gru單元輸出的節點個數 即隱藏層節點數
    :return: 返回靜態單層GRU單元的輸出,以及cell狀態
    """
    # 把輸入input_x按列拆分,並返回一個有n_steps個張量組成的list
    # 如batch_sizex28x28的輸入拆成[(batch_size,28),((batch_size,28))....]
    # 如果是調用的是靜態rnn函數,需要這一步處理   即相當於把序列作為第一維度
    input_x = tf.unstack(input, num=time_steps, axis=1)
    gru_cell = tf.nn.rnn_cell.GRUCell(num_units=hidden_size)  # 創建GRU_cell
    # 靜態rnn函數傳入的是一個張量list  每一個元素都是一個(batch_size,input_size)大小的張量
    output, states = tf.nn.static_rnn(cell=gru_cell, inputs=input_x, dtype=tf.float32)  # 通過cell類構建RNN

    return output, states


# 單層動態LSTM
def single_layer_dynamic_lstm(input, time_steps, hidden_size):
    """
    :param input_x: 輸入張量 形狀為[batch_size, time_steps, input_size]
    :param time_steps: 時序總數
    :param hidden_size: LSTM單元輸出的節點個數 即隱藏層節點數
    :return: 返回動態單層LSTM單元的輸出,以及cell狀態
    """
    lstm_cell = tf.nn.rnn_cell.BasicLSTMCell(num_units=hidden_size)  # 創建LSTM_cell
    # 動態rnn函數傳入的是一個三維張量,[batch_size,time_steps, input_size]  輸出也是這種形狀
    output, states = tf.nn.dynamic_rnn(cell=lstm_cell, inputs=input, dtype=tf.float32)  # 通過cell類構建RNN
    output = tf.transpose(output, [1, 0, 2])  # 注意這裏輸出需要轉置  轉換為時序優先的
    return output, states


# 單層動態gru
def single_layer_dynamic_gru(input, time_steps, hidden_size):
    """
    :param input: 輸入張量 形狀為[batch_size, time_steps, input_size]
    :param time_steps: 時序總數
    :param hidden_size: GRU單元輸出的節點個數 即隱藏層節點數
    :return: 返回動態單層GRU單元的輸出,以及cell狀態
    """
    gru_cell = tf.nn.rnn_cell.GRUCell(num_units=hidden_size)  # 創建GRU_cell
    # 動態rnn函數傳入的是一個三維張量,[batch_size,n_steps,input_size]  輸出也是這種形狀
    output, states = tf.nn.dynamic_rnn(cell=gru_cell, inputs=input, dtype=tf.float32)  # 通過cell類構建RNN
    output = tf.transpose(output, [1, 0, 2])  # 注意這裏輸出需要轉置  轉換為時序優先的
    return output, states

View Code

多層 靜態/動態 LSTM/GRU

#######################################
#       多層 靜態/動態 LSTM/GRU        #
#######################################
# 多層靜態LSTM網絡
def multi_layer_static_lstm(input, time_steps, hidden_size):
    """
    :param input: 輸入張量 形狀為[batch_size,time_steps,input_size]
    :param time_steps: 時序總數
    :param n_hidden: LSTM單元輸出的節點個數 即隱藏層節點數
    :return: 返回靜態多層LSTM單元的輸出,以及cell狀態
    """
    # 把輸入input_x按列拆分,並返回一個有n_steps個張量組成的list
    # 如batch_sizex28x28的輸入拆成[(batch_size,28),((batch_size,28))....]
    # 如果是調用的是靜態rnn函數,需要這一步處理   即相當於把序列作為第一維度
    input_x1 = tf.unstack(input, num=time_steps, axis=1)

    # 多層RNN的實現 例如cells=[cell1,cell2,cell3],則表示一共有三層
    mcell = tf.nn.rnn_cell.MultiRNNCell(
        [tf.nn.rnn_cell.LSTMCell(num_units=hidden_size) for _ in range(3)])

    # 靜態rnn函數傳入的是一個張量list  每一個元素都是一個(batch_size,input_size)大小的張量
    output, states = tf.nn.static_rnn(cell=mcell, inputs=input_x1, dtype=tf.float32)

    return output, states


# 多層靜態GRU
def multi_layer_static_gru(input, time_steps, hidden_size):
    """
    :param input_x: 輸入張量 形狀為[batch_size,n_steps,input_size]
    :param time_steps: 時序總數
    :param hidden_size: gru單元輸出的節點個數 即隱藏層節點數
    :return: 返回靜態多層GRU單元的輸出,以及cell狀態
    """
    # 把輸入input_x按列拆分,並返回一個有n_steps個張量組成的list
    # 如batch_sizex28x28的輸入拆成[(batch_size,28),((batch_size,28))....]
    # 如果是調用的是靜態rnn函數,需要這一步處理   即相當於把序列作為第一維度
    input_x = tf.unstack(input, num=time_steps, axis=1)

    # 多層RNN的實現 例如cells=[cell1,cell2,cell3],則表示一共有三層
    mcell = tf.nn.rnn_cell.MultiRNNCell(
        [tf.nn.rnn_cell.GRUCell(num_units=hidden_size) for _ in range(3)])

    # 靜態rnn函數傳入的是一個張量list  每一個元素都是一個(batch_size,input_size)大小的張量
    output, states = tf.nn.static_rnn(cell=mcell, inputs=input_x, dtype=tf.float32)

    return output, states


# 多層靜態GRU和LSTM 混合
def multi_layer_static_mix(input, time_steps, hidden_size):
    """
    :param input: 輸入張量 形狀為[batch_size,n_steps,input_size]
    :param time_steps: 時序總數
    :param hidden_size: gru單元輸出的節點個數 即隱藏層節點數
    :return: 返回靜態多層GRU和LSTM混合單元的輸出,以及cell狀態
    """
    # 把輸入input_x按列拆分,並返回一個有n_steps個張量組成的list
    # 如batch_sizex28x28的輸入拆成[(batch_size,28),((batch_size,28))....]
    # 如果是調用的是靜態rnn函數,需要這一步處理   即相當於把序列作為第一維度
    input_x = tf.unstack(input, num=time_steps, axis=1)

    # 可以看做2個隱藏層
    lstm_cell = tf.nn.rnn_cell.LSTMCell(num_units=hidden_size)
    gru_cell = tf.nn.rnn_cell.GRUCell(num_units=hidden_size * 2)

    # 多層RNN的實現 例如cells=[cell1,cell2],則表示一共有兩層,數據經過cell1后還要經過cells
    mcell = tf.nn.rnn_cell.MultiRNNCell(cells=[lstm_cell, gru_cell])

    # 靜態rnn函數傳入的是一個張量list  每一個元素都是一個(batch_size,input_size)大小的張量
    output, states = tf.nn.static_rnn(cell=mcell, inputs=input_x, dtype=tf.float32)

    return output, states


# 多層動態LSTM
def multi_layer_dynamic_lstm(input, time_steps, hidden_size):
    """
    :param input: 輸入張量  形狀為[batch_size,n_steps,input_size]
    :param time_steps: 時序總數
    :param hidden_size: LSTM單元輸出的節點個數 即隱藏層節點數
    :return: 返回動態多層LSTM單元的輸出,以及cell狀態
    """
    # 多層RNN的實現 例如cells=[cell1,cell2],則表示一共有兩層,數據經過cell1后還要經過cells
    mcell = tf.nn.rnn_cell.MultiRNNCell(
        [tf.nn.rnn_cell.LSTMCell(num_units=hidden_size) for _ in range(3)])

    # 動態rnn函數傳入的是一個三維張量,[batch_size,n_steps,input_size]  輸出也是這種形狀
    output, states = tf.nn.dynamic_rnn(cell=mcell, inputs=input, dtype=tf.float32)

    # 注意這裏輸出需要轉置  轉換為時序優先的
    output = tf.transpose(output, [1, 0, 2])
    return output, states


# 多層動態GRU
def multi_layer_dynamic_gru(input, time_steps, hidden_size):
    """
    :param input: 輸入張量 形狀為[batch_size,n_steps,input_size]
    :param time_steps: 時序總數
    :param hidden_size: gru單元輸出的節點個數 即隱藏層節點數
    :return: 返回動態多層GRU單元的輸出,以及cell狀態
    """
    # 多層RNN的實現 例如cells=[cell1,cell2],則表示一共有兩層,數據經過cell1后還要經過cells
    mcell = tf.nn.rnn_cell.MultiRNNCell(
        [tf.nn.rnn_cell.GRUCell(num_units=hidden_size) for _ in range(3)])

    # 動態rnn函數傳入的是一個三維張量,[batch_size,n_steps,input_size]  輸出也是這種形狀
    output, states = tf.nn.dynamic_rnn(cell=mcell, inputs=input, dtype=tf.float32)

    # 注意這裏輸出需要轉置  轉換為時序優先的
    output = tf.transpose(output, [1, 0, 2])
    return output, states


# 多層動態GRU和LSTM 混合
def multi_layer_dynamic_mix(input, time_steps, hidden_size):
    """
    :param input: 輸入張量 形狀為[batch_size,n_steps,input_size]
    :param time_steps: 時序總數
    :param hidden_size: gru單元輸出的節點個數 即隱藏層節點數
    :return: 返回動態多層GRU和LSTM混合單元的輸出,以及cell狀態
    """
    # 可以看做2個隱藏層
    gru_cell = tf.nn.rnn_cell.GRUCell(num_units=hidden_size * 2)
    lstm_cell = tf.nn.rnn_cell.LSTMCell(num_units=hidden_size)

    # 多層RNN的實現 例如cells=[cell1,cell2],則表示一共有兩層,數據經過cell1后還要經過cells
    mcell = tf.nn.rnn_cell.MultiRNNCell(cells=[lstm_cell, gru_cell])

    # 動態rnn函數傳入的是一個三維張量,[batch_size,n_steps,input_size]  輸出也是這種形狀
    output, states = tf.nn.dynamic_rnn(cell=mcell, inputs=input, dtype=tf.float32)

    # 注意這裏輸出需要轉置  轉換為時序優先的
    output = tf.transpose(output, [1, 0, 2])
    return output, states

View Code

單層/多層 雙向 靜態/動態 LSTM/GRU

#######################################
#   單層/多層 雙向 靜態/動態 LSTM/GRU   #
#######################################
# 單層靜態雙向LSTM
def single_layer_static_bi_lstm(input, time_steps, hidden_size):
    """
    :param input: 輸入張量 形狀為[batch_size,time_steps,input_size]
    :param time_steps: 時序總數
    :param hidden_size: LSTM單元輸出的節點個數 即隱藏層節點數
    :return: 返回單層靜態雙向LSTM單元的輸出,以及cell狀態
    """
    # 把輸入input_x按列拆分,並返回一個有n_steps個張量組成的list
    # 如batch_sizex28x28的輸入拆成[(batch_size,28),((batch_size,28))....]
    # 如果是調用的是靜態rnn函數,需要這一步處理   即相當於把序列作為第一維度
    input_x = tf.unstack(input, num=time_steps, axis=1)
    lstm_fw_cell = tf.nn.rnn_cell.BasicLSTMCell(num_units=hidden_size)  # 正向
    lstm_bw_cell = tf.nn.rnn_cell.BasicLSTMCell(num_units=hidden_size)  # 反向

    # 靜態rnn函數傳入的是一個張量list  每一個元素都是一個(batch_size,input_size)大小的張量
    # 這裏的輸出output是一個list 每一個元素都是前向輸出,後向輸出的合併
    output, fw_state, bw_state = tf.nn.static_bidirectional_rnn(cell_fw=lstm_fw_cell,
                                                                cell_bw=lstm_bw_cell,
                                                                inputs=input_x,
                                                                dtype=tf.float32)
    print(type(output))  # <class 'list'>
    print(len(output))  # 28
    print(output[0].shape)  # (?, 256)

    return output, fw_state, bw_state


# 單層動態雙向LSTM
def single_layer_dynamic_bi_lstm(input, time_steps, hidden_size):
    """
    :param input: 輸入張量 形狀為[batch_size,time_steps,input_size]
    :param time_steps: 時序總數
    :param hidden_size: gru單元輸出的節點個數 即隱藏層節點數
    :return: 返回單層動態雙向LSTM單元的輸出,以及cell狀態
    """
    lstm_fw_cell = tf.nn.rnn_cell.BasicLSTMCell(num_units=hidden_size)  # 正向
    lstm_bw_cell = tf.nn.rnn_cell.BasicLSTMCell(num_units=hidden_size)  # 反向

    # 動態rnn函數傳入的是一個三維張量,[batch_size,time_steps,input_size]  輸出是一個元組 每一個元素也是這種形狀
    output, state = tf.nn.bidirectional_dynamic_rnn(cell_fw=lstm_fw_cell,
                                                    cell_bw=lstm_bw_cell,
                                                    inputs=input,
                                                    dtype=tf.float32)
    print(type(output))  # <class 'tuple'>
    print(len(output))  # 2
    print(output[0].shape)  # (?, 28, 128)
    print(output[1].shape)  # (?, 28, 128)

    output = tf.concat(output, axis=2)  # 按axis=2合併 (?,28,128) (?,28,128)按最後一維合併(?,28,256)
    output = tf.transpose(output, [1, 0, 2])  # 注意這裏輸出需要轉置  轉換為時序優先的

    return output, state


# 多層靜態雙向LSTM
def multi_layer_static_bi_lstm(input, time_steps, hidden_size):
    """
    :param input: 輸入張量 形狀為[batch_size,time_steps,input_size]
    :param time_steps: 時序總數
    :param hidden_size: LSTM單元輸出的節點個數 即隱藏層節點數
    :return: 返回多層靜態雙向LSTM單元的輸出,以及cell狀態
    """
    # 把輸入input_x按列拆分,並返回一個有n_steps個張量組成的list
    # 如batch_sizex28x28的輸入拆成[(batch_size,28),((batch_size,28))....]
    # 如果是調用的是靜態rnn函數,需要這一步處理   即相當於把序列作為第一維度
    input_x = tf.unstack(input, num=time_steps, axis=1)

    stacked_fw_rnn = []
    stacked_bw_rnn = []
    for i in range(3):
        stacked_fw_rnn.append(tf.nn.rnn_cell.BasicLSTMCell(num_units=hidden_size))  # 正向
        stacked_bw_rnn.append(tf.nn.rnn_cell.BasicLSTMCell(num_units=hidden_size))  # 反向

    # 靜態rnn函數傳入的是一個張量list  每一個元素都是一個(batch_size,input_size)大小的張量
    # 這裏的輸出output是一個list 每一個元素都是前向輸出,後向輸出的合併
    output, fw_state, bw_state = tf.contrib.rnn.stack_bidirectional_rnn(stacked_fw_rnn,
                                                                        stacked_bw_rnn,
                                                                        inputs=input_x,
                                                                        dtype=tf.float32)
    print(type(output))  # <class 'list'>
    print(len(output))  # 28
    print(output[0].shape)  # (?, 256)

    return output, fw_state, bw_state


# 多層動態雙向LSTM
def multi_layer_dynamic_bi_lstm(input, time_steps, hidden_size):
    """
    :param input: 輸入張量 形狀為[batch_size,n_steps,input_size]
    :param time_steps: 時序總數
    :param hidden_size: gru單元輸出的節點個數 即隱藏層節點數
    :return: 返回多層動態雙向LSTM單元的輸出,以及cell狀態
    """
    stacked_fw_rnn = []
    stacked_bw_rnn = []
    for i in range(3):
        stacked_fw_rnn.append(tf.nn.rnn_cell.BasicLSTMCell(num_units=hidden_size))  # 正向
        stacked_bw_rnn.append(tf.nn.rnn_cell.BasicLSTMCell(num_units=hidden_size))  # 反向

    # 動態rnn函數傳入的是一個三維張量,[batch_size,n_steps,input_size]  輸出也是這種形狀,
    # input_size變成了正向和反向合併之後的 即input_size*2
    output, fw_state, bw_state = tf.contrib.rnn.stack_bidirectional_dynamic_rnn(stacked_fw_rnn,
                                                                                stacked_bw_rnn,
                                                                                inputs=input,
                                                                                dtype=tf.float32)
    print(type(output))  # <class 'tensorflow.python.framework.ops.Tensor'>
    print(output.shape)  # (?, 28, 256)

    output = tf.transpose(output, [1, 0, 2])  # 注意這裏輸出需要轉置  轉換為時序優先的

    return output, fw_state, bw_state

View Code

然後我們定義神經網絡框架

※台中搬家遵守搬運三大原則,讓您的家具不再被破壞!

台中搬家公司推薦超過30年經驗,首選台中大展搬家

def RNN_inference(inputs, class_num, time_steps, hidden_size):
    """
    :param inputs: [batch_size, n_steps, input_size]
    :param class_num: 類別數
    :param time_steps: 時序總數
    :param n_hidden: LSTM單元輸出的節點個數 即隱藏層節點數
    """
    #######################################
    #       單層 靜態/動態 LSTM/GRU        #
    #######################################
    # outputs, states = single_layer_static_lstm(inputs, time_steps, hidden_size)  # 單層靜態LSTM
    # outputs, states = single_layer_static_gru(inputs, time_steps, hidden_size)   # 單層靜態gru
    # outputs, states = single_layer_dynamic_lstm(inputs, time_steps, hidden_size)  # 單層動態LSTM
    # outputs, states = single_layer_dynamic_gru(inputs, time_steps, hidden_size)  # 單層動態gru
    #######################################
    #       多層 靜態/動態 LSTM/GRU        #
    #######################################
    # outputs, states = multi_layer_static_lstm(inputs, time_steps, hidden_size)  # 多層靜態LSTM網絡
    # outputs, states = multi_layer_static_gru(inputs, time_steps, hidden_size)  # 多層靜態GRU
    # outputs, states = multi_layer_static_mix(inputs, time_steps, hidden_size)  # 多層靜態GRU和LSTM 混合
    # outputs, states = multi_layer_dynamic_lstm(inputs, time_steps, hidden_size)  # 多層動態LSTM
    # outputs, states = multi_layer_dynamic_gru(inputs, time_steps, hidden_size)  # 多層動態GRU
    # outputs, states = multi_layer_dynamic_mix(inputs, time_steps, hidden_size)  # 多層動態GRU和LSTM 混合
    #######################################
    #   單層/多層 雙向 靜態/動態 LSTM/GRU  #
    #######################################
    # outputs, fw_state, bw_state = single_layer_static_bi_lstm(inputs, time_steps, hidden_size)  # 單層靜態雙向LSTM
    # outputs, state = single_layer_dynamic_bi_lstm(inputs, time_steps, hidden_size)  # 單層動態雙向LSTM
    # outputs, fw_state, bw_state = multi_layer_static_bi_lstm(inputs, time_steps, hidden_size)  # 多層靜態雙向LSTM
    outputs, fw_state, bw_state = multi_layer_dynamic_bi_lstm(inputs, time_steps, hidden_size)  # 多層動態雙向LSTM

    # output靜態是 time_step=28個(batch=128, output=128)組成的列表
    # output動態是 (time_step=28, batch=128, output=128)
    print('hidden:', outputs[-1].shape)  # 最後一個時序的shape(128,128)

    # 取LSTM最後一個時序的輸出,然後經過全連接網絡得到輸出值
    fc_output = fc(input=outputs[-1], output_size=class_num, activeation_func=tf.nn.relu)

    return fc_output

設置全局變量和超參數

  在模型訓練之前我們首先會定義一些超參數:batch_size、batch_nums、class_num、epochs、learning_rate

batch_size = FLAGS.batch_size
batch_nums = mnist.train.images.shape[0] // batch_size  # 一個epoch中應該包含多少batch數據
class_num = FLAGS.class_num
epochs = FLAGS.epochs
learning_rate = FLAGS.learning_rate

保存檢查點的地址

############    保存檢查點的地址   ############
checkpoints_dir = FLAGS.checkpoints_dir  # checkpoints
# 如果檢查點不存在,則創建
if not os.path.exists(checkpoints_dir):
    os.makedirs(FLAGS.checkpoints_dir)

創建圖

  這一步可以不設置,因為tensorflow有一個默認圖,我們定義的操作都是在默認圖上的,當然我們也可以定義自己的,方便管理。

######################################################
#                    創建圖                          #
######################################################
graph = tf.Graph()  # 自定義圖
# 在自己的圖中定義數據和操作
with graph.as_default():

佔位符

  一般我們會把input和label做成placeholder,方便我們使用把不同的batch數據傳入網絡,一些其他的超參數也可以做成placeholder,比如learning_rate、dorpout_keep_prob。一般在搭建模型的時候把placeholder的變量傳入模型,在訓練模型sess.run(train_op, feed_dict)的時候通過參數feed_dict={input:真實數據,label:真實標籤} 把真實的數據傳入神經網絡。

inputs = tf.placeholder(dtype="float", shape=[None, 28, 28, 1], name='inputs')
labels = tf.placeholder(dtype="float", shape=[None, class_num], name='labels')
# 看個人喜歡,有的人在初始化定義中就定義了learning_rate,有的人喜歡通過feed傳learning_rate
learning_rate = tf.placeholder("float", None, name='learning_rate')
# 如果網絡結構有dropout層,需要定義keep_probn,如果沒有則不需要
# 訓練的時候需要,測試的時候需要設置成1
keep_prob = tf.placeholder(dtype="float", name='keep_prob')  

搭建模型

  傳進入的都是placeholder數據,不是我們之前整理好的batch數據。

############    搭建模型   ############
logits = alexNet(inputs, class_num, keep_prob=keep_prob)  # 使用placeholder搭建模型

構建損失

  分類任務一般輸出的是每個類別的概率向量,因此模型輸出最後都要經過softmax轉換成概率。一般經過softmax的輸出損失函數都是交叉熵損失函數,tensorflow有將以上兩步合在一起的現成函數 tf.nn.softmax_cross_entropy_with_logits

############    損失函數   ############
loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits(labels=labels, logits=logits))
tf.add_to_collection('losses', loss)
total_loss = tf.add_n(tf.get_collection("loss"))  # total_loss=模型損失+權重正則化損失

自定義損失

  以後更新,歡迎大家催我。

模型精度

  在測試數據集上的精度

############    模型精度   ############
predict = tf.argmax(logits, 1)      # 模型預測結果
accuracy = tf.reduce_mean(tf.cast(tf.equal(predict, tf.argmax(labels, 1)), tf.float32))

自定義度量

  以後更新,歡迎大家催我。

優化器

  創建優化器,更新網絡參數,最小化loss

  優化器的種類有很多種,但是用法都差不多,常用的優化器有:

  • tf.train.AdamOptimizer
  • tf.train.GradientDescentOptimizer

  • tf.train.RMSPropOptimizer

下面以Adam優化器為例

############    優化器   ############
variable_to_train = tf.get_collection(tf.GraphKeys.TRAINABLE_VARIABLES)  # 可訓練變量列表
global_step = tf.Variable(0, trainable=False)    # 訓練step
# 設置學習率衰減
learning_rate = tf.train.exponential_decay(learning_rate=learning_rate,  # 初始學習率
                                           global_step=global_step,
                                           decay_steps=batch_nums,  # 多少步衰減一次
                                           decay_rate=0.1,  # 衰減率
                                           staircase=True)  # 以階梯的形式衰減
# 創建Adam優化器,更新模型參數,最小化損失函數
train_op = tf.train.AdamOptimizer(learning_rate).minimize(loss=total_loss,  # 損失函數
                                                          global_step=global_step,
                                                          var_list=variable_to_train)  # 通過訓練需要更新的參數列表

講解:

  • variable_to_train:上面的代碼定義了可訓練變量,我只是把列出了模型默認的可訓練變量,這一個步是tensorflow默認的,如果不設置也沒有關係。我寫出來的原因是,有的大牛會這麼寫,對不同的可訓練變量分別進行不同的優化,希望大家看到我的代碼,下次看到別人的不會覺得陌生。
  • global_step:大多數人會用step=0,然後在訓練的時候step+=1的方式更新step,但是本文介紹的是另一種方式,以tf.Variable的方式定義step,在模型訓練的時候傳入sess.run,global_step會自動+1更新
  • learning_rate:本文還設置了學習率衰減,大家也可以不設置,以固定的學習率訓練模型,但是對於大型項目,還是推薦設置。

移動平均值更新參數

採用移動平均值的方式更新損失值和模型參數

def train(total_loss, global_step):
    lr = tf.train.exponential_decay(0.01, global_step, decay_steps=350, decay_rate=0.1, staircase=True)
    # 採用滑動平均的方法更新損失值
    loss_averages = tf.train.ExponentialMovingAverage(decay=0.9, name='avg')
    losses = tf.get_collection('losses')  # losses的列表
    loss_averages_op = loss_averages.apply(losses + [total_loss])  # 計算損失值的影子變量op

    # 計算梯度
    with tf.control_dependencies([loss_averages_op]):  # 控制計算指定,只有執行了括號中的語句才能執行下面的語句
        opt = tf.train.GradientDescentOptimizer(lr)  # 創建優化器
        grads = opt.compute_gradients(total_loss)  # 計算梯度

    # 應用梯度
    apply_gradient_op = opt.apply_gradients(grads, global_step=global_step)

    # 採用滑動平均的方法更新參數
    variable_averages = tf.train.ExponentialMovingAverage(0.999, num_updates=global_step)
    variables_averages_op = variable_averages.apply(tf.trainable_variables())

    with tf.control_dependencies([apply_gradient_op, variables_averages_op]):
        # tf.no_op()表示執行完apply_gradient_op, variable_averages_op操作之後什麼都不做
        train_op = tf.no_op(name='train')

    return train_op

View Code

TensorBoard可視化 summary

############    TensorBoard可視化 summary  ############
summary_writer = tf.summary.FileWriter(logdir="./logs", graph=graph)  # 創建事件文件
tf.summary.scalar(name="losses", tensor=total_loss)  # 收集損失值變量
tf.summary.scalar(name="acc", tensor=accuracy)  # 收集精度值變量
tf.summary.scalar(name='learning_rate', tensor=learning_rate)
merged_summary_op = tf.summary.merge_all()  # 將所有的summary合併為一個op

模型保存和恢復 Saver

saver = tf.train.Saver(max_to_keep=5)  # 保存最新的5個檢查點

創建會話

配置會話

  在創建會話之前我們一般都要配置會話,比如使用GPU還是CPU,用多少GPU等等。

我們一般使用 tf.ConfigProto()配置Session運行參數&&GPU設備指定

config = tf.ConfigProto(allow_soft_placement=True, log_device_placement=True)
config.gpu_options.per_process_gpu_memory_fraction = 0.4  # 佔用40%顯存 sess = tf.Session(config=config)
# 或者
config = tf.ConfigProto()
config.allow_soft_placement = True
config.log_device_placement = True

with tf.Session(config=config) as sess:
# 或者
sess = tf.Session(config=config)

tf.ConfigProto(log_device_placement=True):記錄設備指派情況

  設置tf.ConfigProto()中參數log_device_placement = True,獲取 operations 和 Tensor 被指派到哪個設備(幾號CPU或幾號GPU)上運行,會在終端打印出各項操作是在哪個設備上運行的。

tf.ConfigProto(allow_soft_placement=True):自動選擇運行設備

  在TensorFlow中,通過命令 “with tf.device(‘/cpu:0’):“,允許手動設置操作運行的設備。如果手動設置的設備不存在或者不可用,就會導致tf程序等待或異常,為了防止這種情況,可以設置tf.ConfigProto()中參數allow_soft_placement=True,自動選擇一個存在並且可用的設備來運行操作。

config.gpu_options.allow_growth = True

當使用GPU時候,Tensorflow運行自動慢慢達到最大GPU的內存

tf.test.is_built_with_cuda():返回是否能夠使用GPU進行運算

  為了加快運行效率,TensorFlow在初始化時會嘗試分配所有可用的GPU顯存資源給自己,這在多人使用的服務器上工作就會導致GPU佔用,別人無法使用GPU工作的情況。這時我們需要限制GPU資源使用,詳細實現方法請參考我的另一篇博客 tensorflow常用函數 Ctrl+F搜索“限制GPU資源使用”

創建會話Session

  Session有兩種創建方式:

sess = tf.Session(config=config, graph=graph)
# 或通過with的方式創建Session
with tf.Session(config=config, graph=graph) as sess:

  如果我們之前自定義了graph,則在會話中也要配置graph,如果之前沒有自定義graph,使用的是tensorflow默認graph,則在會話不用自己去定義,tensorflow會自動找到默認圖。

  在訓練模型之前我們首先要設置一個高級一點的東西,那就是檢查是否有之前保存好的模型,如果有着接着前面的繼續訓練,如果沒有則從頭開始訓練模型。

恢復/重新訓練

  定義一個檢查模型是否存在的函數,為了美觀,可以把這個函數放在最上面,或者其他腳本中,通過import導入。

def load_model(sess, saver, checkpoint_dir):
    """加載模型,看看還能不能加一個功能,必須現在的檢查檢點是1000,但是我的train是100,要報錯
        還有就是讀取之前的模型繼續訓練的問題
        checkpoint_dir = checkpoint"""

    # 通過checkpoint找到模型文件名
    ckpt = tf.train.get_checkpoint_state(checkpoint_dir=checkpoint_dir)
    if ckpt and ckpt.model_checkpoint_path:
        ckpt_name = os.path.basename(ckpt.model_checkpoint_path)  # 返回最新的chechpoint文件名 model.ckpt-1000
        print("新的chechpoint文件名", ckpt_name)  # model.ckpt-2
        saver.restore(sess, os.path.join(checkpoint_dir, ckpt_name))
        # 現在不知道checkpoint文件名時怎樣的,因此不知道裏面如何運行
        counter = int(next(re.finditer("(\d+)(?!.*\d)", ckpt_name)).group(0))  # 2
        print(" [*] 成功模型 {}".format(ckpt_name))
        return True, counter
    else:
        print(" [*] 找不到checkpoint")
        return False, 0

View Code

  如果大家之前用的是global_step = tf.Variable(0, trainable=False),則使用下面diamante

# 加載模型,如果模型存在返回 是否加載成功和訓練步數
could_load, checkpoint_step = load_model(sess, saver, "./log")
if could_load:
    print(" [*] 加載成功")
else:
    print(" [!] 加載失敗")
    try:
        tf.global_variables_initializer().run()
    except:
        tf.initialize_all_variables().run()

  如果大家想使用step=0,step+=1,則可以使用下面代碼

# 加載模型,如果模型存在返回 是否加載成功和訓練步數
could_load, checkpoint_step = load_model(sess, saver, FLAGS.checkpoints_dir)
if could_load:
    step = checkpoint_step
    print(" [*] 模型加載成功")
else:
    print(" [!] 模型加載失敗")
    try:
        tf.global_variables_initializer().run()
    except:
        tf.initialize_all_variables().run()
    step = 0

開始訓練

for epoch in range(epochs):
    for i in range(batch_nums):
        start_time = time.time()
        # batch_images = data_X[i * batch_size:(i + 1) * batch_size]
        # batch_labels = data_y[i * batch_size:(i + 1) * batch_size]
        train_batch_x, train_batch_y = mnist.train.next_batch(batch_size)

        # 使用真實數據填充placeholder,運行訓練模型和合併變量操作
        _, summary, loss, step = sess.run([train_op, merged_summary_op, total_loss, global_step],
                                          feed_dict={inputs: train_batch_x,
                                                     labels: train_batch_y,
                                                     keep_prob: 0.5})
        if step % 100 == 0:
            summary_writer.add_summary(summary, step)  # 將每次迭代后的變量寫入事件文件
            summary_writer.flush()  # 強制summary_writer將緩存中的數據寫入到日誌文件中(可選)

            ############    可視化打印   ############
            print("Epoch:[%2d] [%4d/%4d] time:%4.4f,loss:%.8f" % (
                epoch, i, batch_nums, time.time() - start_time, loss))

        # 打印一些可視化的數據,損失...
        if step % 100 == 0:
            acc = sess.run(accuracy, feed_dict={inputs: mnist.validation.images,
                                                labels: mnist.validation.labels,
                                                keep_prob: 1.0})
            print("Epoch:[%2d] [%4d/%4d] accuracy:%.8f" % (epoch, i, batch_nums, acc))
            ############    保存模型   ############
            if acc > max_acc:
                max_acc = acc
                save_path = saver.save(sess,
                                       save_path=os.path.join(checkpoints_dir, "model.ckpt"),
                                       global_step=step)
                tf.logging.info("模型保存在: %s" % save_path)
print("優化完成!")

模型評估

eval.py

模型評估的代碼和模型訓練的代碼很像,只不過不需要對模型進行訓練而已。

from ops import *
import tensorflow as tf
from nets.my_alex import alexNet
from tensorflow.examples.tutorials.mnist import input_data

tf.flags.DEFINE_integer('batch_size', 50, 'batch size, default: 1')
tf.flags.DEFINE_integer('class_num', 10, 'batch size, default: 1')
tf.flags.DEFINE_integer('epochs', 10, 'batch size, default: 1')
tf.flags.DEFINE_string('checkpoints_dir', "checkpoints", '保存檢查點的地址')
FLAGS = tf.flags.FLAGS

# 從MNIST_data/中讀取MNIST數據。當數據不存在時,會自動執行下載
mnist = input_data.read_data_sets('./data', one_hot=True, reshape=False)

# 將數組張換成圖片形式
print(mnist.train.images.shape)  # 訓練數據圖片(55000, 28, 28, 1)
print(mnist.train.labels.shape)  # 訓練數據標籤(55000, 10)
print(mnist.test.images.shape)  # 測試數據圖片(10000, 28, 28, 1)
print(mnist.test.labels.shape)  # 測試數據圖片(10000, 10)
print(mnist.validation.images.shape)  # 驗證數據圖片(5000, 28, 28, 1)
print(mnist.validation.labels.shape)  # 驗證數據圖片(5000, 10)


def evaluate():
    batch_size = FLAGS.batch_size
    batch_nums = mnist.train.images.shape[0] // batch_size  # 一個epoch中應該包含多少batch數據
    class_num = FLAGS.class_num
    test_batch_size = 5000
    test_batch_num = mnist.test.images.shape[0] // test_batch_size

    ############    保存檢查點的地址   ############
    checkpoints_dir = FLAGS.checkpoints_dir  # checkpoints
    # 如果檢查點不存在,則創建
    if not os.path.exists(checkpoints_dir):
        print("模型文件不存在,無法進行評估")

    ######################################################
    #                    創建圖                          #
    ######################################################
    graph = tf.Graph()  # 自定義圖
    # 在自己的圖中定義數據和操作
    with graph.as_default():
        inputs = tf.placeholder(dtype="float", shape=[None, 28, 28, 1], name='inputs')
        labels = tf.placeholder(dtype="float", shape=[None, class_num], name='labels')
        ############    搭建模型   ############
        logits = alexNet(inputs, FLAGS.class_num, keep_prob=1)  # 使用placeholder搭建模型
        ############    模型精度   ############
        predict = tf.argmax(logits, 1)
        accuracy = tf.reduce_mean(tf.cast(tf.equal(predict, tf.argmax(labels, 1)), tf.float32))
        ############    模型保存和恢復 Saver   ############
        saver = tf.train.Saver(max_to_keep=5)

    ######################################################
    #                   創建會話                          #
    ######################################################
    config = tf.ConfigProto(allow_soft_placement=True, log_device_placement=True)
    with tf.Session(config=config, graph=graph) as sess:
        # 加載模型,如果模型存在返回 是否加載成功和訓練步數
        could_load, checkpoint_step = load_model(sess, saver, FLAGS.checkpoints_dir)
        if could_load:
            print(" [*] 加載成功")
        else:
            print(" [!] 加載失敗")
            raise ValueError("模型文件不存在,無法進行評估")

        for i in range(test_batch_num):
            test_batch_x, test_batch_y = mnist.test.next_batch(test_batch_num)
            acc = sess.run(accuracy, feed_dict={inputs: test_batch_x,
                                                labels: test_batch_y})
            print("模型精度為:", acc)
        one_image = mnist.test.images[1].reshape(1, 28, 28, 1)
        predict_label = sess.run(predict, feed_dict={inputs: one_image})
        # print("123", tf.argmax(pre_yyy, 1).eval())  # [7]
        # print("123", tf.argmax(yyy, 1).eval())  # 7


def main(argv=None):
    evaluate()


if __name__ == '__main__':
    tf.app.run()


參考文獻

CSDN_AlexNet神經網絡結構

CSDN_【深度學習理論3】ALexNet模型的詳解

github搜索tensorflow AlexNet

github_finetune_alexnet_with_tensorflow

github_AlexNet_with_tensorflow

github tensorflow vgg

ResNet詳解與分析

tensorflow中使用tf.ConfigProto()配置Session運行參數&&GPU設備指定

比較完整且容易入門的MNIST案例

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※台中搬家遵守搬運三大原則,讓您的家具不再被破壞!

台中搬家公司推薦超過30年經驗,首選台中大展搬家

Golang-自動化監控教務系統成績單_台中搬家公司

※台中搬家公司教你幾個打包小技巧,輕鬆整理裝箱!

還在煩惱搬家費用要多少哪?台中大展搬家線上試算搬家費用,從此不再擔心「物品怎麼計費」、「多少車才能裝完」

目錄

  • 一、Golang模擬用戶登陸,突破教務系統
    • 1.1 請求登陸頁面
    • 1.2 抓包分析登陸請求
    • 1.3 golang使用js引擎合成salt
    • 1.4 模擬表單提交,完成登陸
    • 1.5 進入成績查詢頁,解析用戶成績
  • 二、植入微信公共號後台

一、Golang模擬用戶登陸,突破教務系統

1.1 請求登陸頁面

整個流程中的第一步是獲取登陸頁面,就像下圖這樣人為的通過瀏覽器訪問服務端,服務端返回反饋返回登陸頁面

訪問登陸頁面的目的上圖中標註出來了,為了獲取到Cookie,給真正發起登陸到請求方法使用。

下面的golang發送http到get請求,獲取登陸頁面的代碼:

// 訪問登陸也,獲取cookie
func GetCookieFromLoginhtml(url string) (cookie string, e error) {
   res, err := http.Get(url)
   if err != nil {
   	e = err
   }
   // 獲取cookie
   cookie = res.Header.Get("Set-Cookie")
   cookie = util.GetOneValueByPrefixAndSurfix("JSESSIONID=", "; Path=/", cookie)
   res.Body.Close()
   return
}

1.2 抓包分析登陸請求

輸入賬號賬號密碼後點擊登陸,將向後端發送登陸請求,如下圖:

分析向後端發送到登陸請求都攜帶了哪些請求參數,攜帶了哪些請求頭信息,以及需要通過Content-Type判斷,該如何處理form表單中的數據發送到後台。後台才能正常響應。

在瀏覽器的控制台中我們可以去看下登陸頁面源碼

登陸頁面對應的js源碼

1.3 golang使用js引擎合成salt

這一步也是必須的,所謂獲取salt,其實就是通過golang使用js引擎執行encodeInp(xxx), 這樣我們才能得到經過加密后的username和password,進一步獲取到encoded

import (
	"github.com/robertkrimen/otto"
	"io/ioutil"
)
func EncodeInp(input string)(result string,e error)  {
	jsfile := "js/encodeUriJs.js"
	bytes, err := ioutil.ReadFile(jsfile)
	if err != nil {
		e = err
	}
	vm := otto.New()
	_, err = vm.Run(string(bytes))
	if err != nil {
		e = err
	}
	enc,err :=vm.Call("encodeInp",nil,input)
	if err != nil {
		e = err
	}
	result = enc.String()
	return
}

js部分的代碼就不往外貼了,可以去下面的github地址中獲取

1.4 模擬表單提交,完成登陸

使用golang模擬登陸請求

※推薦台中搬家公司優質服務,可到府估價

台中搬鋼琴,台中金庫搬運,中部廢棄物處理,南投縣搬家公司,好幫手搬家,西屯區搬家

// 模擬登陸
func login(salt, cookie string) (html string) {
	
	req, err := http.NewRequest("POST", LoginUrl, strings.NewReader("encoded="+salt))
  
	// 添加請求頭
	req.Header.Add("User-Agent", "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.163 Safari/537.36")
	req.Header.Add("Cookie", "JSESSIONID="+cookie)
	req.Header.Add("Content-Type", "application/x-www-form-urlencoded")
	req.Header.Add("Accept", "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.9")

	//發送請求
	client := &http.Client{}
	resp, err := client.Do(req)
	if err != nil {
		fmt.Printf("無密版qlu教務系統登陸請求失敗 : %v", err)
		return
	}
	// todo 根據狀態碼判斷下一步如何操作,如果狀態碼是302,表示操作成功
	fmt.Println("resp.Status:  ", resp.Status)

	b, err := ioutil.ReadAll(resp.Body)
	if err != nil {
		fmt.Printf("error : %v", err)
		return
	}
	// 返回個人主頁的html
	html = string(b)
	// 手動關閉
	resp.Body.Close()
	return
}

這一步中值得注意的地方:

第一:我們發送的請求的類型是POST請求

第二:我們應該如何處理form表單中的數據后,再發送給後端,後端才能正常處理呢?

具體處理成什麼樣,是需要根據請求頭中的Content-Type決定的。

不知道大家知不知道常見的Content-Type的幾種類型:在form 表單中有一個屬性叫做 entype可以間接將數據處理成Content-Type指定數據格式, 比如我們可以像這樣設置:

  • enctype = text/plain 那麼form表單最終提交的格式就是: 用純文本的形式發送。

  • enctype = application/x-www-form-urlencoded

    • 表單中的enctype值如果不設置,則默認是application/x-www-form-urlencoded,它會將表單中的數據變為鍵值對的形式。
    • 如果action為get,則將表單數據編碼為(name1=value1&name2=value2…),然後把這個字符串加到url後面,中間用?分隔。
    • 如果action為post,瀏覽器把form數據封裝到http body中,然後發送到服務器。
  • enctype = mutipart/form-data

    • 上傳的是非文本內容,比如是個圖片,文件,mp3。

根據這個知識點,結合我們當前的情況,method=post,Content-Type = application/x-www-form-urlencoded

所以,在選擇golang的api時,我們選擇下圖這個api使用

1.5 進入成績查詢頁,解析用戶成績

如果不出意外,經過上面的處理,我們已經完成登陸,並且獲取到後台頁面的html源碼了。

再之後我們就直奔成績查詢模塊,還是使用如何的分析思路

func getAllScore(stuIdentify, cookie string) ([]mtStruct.Score, error) {
	// 發送查詢成績的請求
	u := "http://jwxt.qlu.edu.cn/jsxsd/kscj/cjcx_list"
	req, err := http.NewRequest("POST", u, strings.NewReader("kksj=&kcxz=&kcmc=&xsfs=all"))
	if err != nil {
		fmt.Printf("error : %v", err)
		return nil, err
	}
	req.Header.Add("User-Agent", "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.163 Safari/537.36")
	req.Header.Add("Cookie", "JSESSIONID="+cookie)
	req.Header.Add("Referer", "http://jwxt.qlu.edu.cn/jsxsd/kscj/cjcx_query?Ves632DSdyV=NEW_XSD_XJCJ")
	req.Header.Add("Accept", "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*;q=0.8,application/signed-exchange;v=b3;q=0.9")

	client := &http.Client{}
	resp, err := client.Do(req)
  ...
  
}

代碼詳情可以去github上查看。

二、植入微信公共號後台

上面的功能實現后再結合Golang開發微信公眾號就能實現一款好玩的應用。

讓用戶通過微信公共號平台和後端進行數據的交互,我們獲取到用戶的信息,拿着用戶的信息幫用戶監聽教務系統的成績單的狀態。一旦有成績第一時間推送給用戶。

點擊查看公眾號端設計思路

項目GitHub地址:https://github.com/zhuchangwu/golang-wechat-backend

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※台中搬家公司教你幾個打包小技巧,輕鬆整理裝箱!

還在煩惱搬家費用要多少哪?台中大展搬家線上試算搬家費用,從此不再擔心「物品怎麼計費」、「多少車才能裝完」

小米的“鐵蹄”_網頁設計公司

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!

以設計的實用美學觀點,規劃出舒適、美觀的視覺畫面,有效提昇使用者的心理期待,營造出輕鬆、愉悅的網站瀏覽體驗。

雷軍說,小米的模式是「互聯網+製造」。

這顯然指的是現在的小米,一個不同於2010年成立之初,為了一塊手機屏幕、一家代工廠商忙得焦頭爛額的小米。

在過往十年裡,小米恰如其時地趕上了智能手機的全生命周期,從開局到全盛、再到如今的幾近飽和,智能手機成就了移動互聯網,也成就了小米。

小米卻不僅僅是一家手機廠商,至少在這位當時已將金山軟件送上港交所、在投行浸潤多年的知名投資人眼裡,小米應該有更大的格局。

“其實很多人不懂小米,”在接受《中國企業家》採訪時,雷軍如是說。

過往幾年,雷軍多次強調“小米從來都不是一家只做硬件的公司”。實際上,小米在成立之初甚至差點兒成了下一個騰訊。

即使在最終選定智能手機賽道后,小米也一再出圈,做生態鏈、做家電、做物聯網、做“地產”……

「互聯網+製造」,也只不過是小米又一次打破常規的瘋狂生長。

差點兒成了下一個騰訊

小米之所以是小米,是因為智能手機。

其實,在小米成立之初,也曾抓到過另一個機遇,IM(即時通訊)。

2010年10月19日,加拿大滑鐵盧大學一個學生團隊研發出了一款軟件,名為Kik Message。

這是一款基於本地通訊錄與聯繫人直接建立聯繫,並在此基礎上實現免費短信聊天的即時通訊工具,發布兩周內,註冊用戶數就超過了100萬。

當時,本來打算做智能手機、對移動互聯網行業高度關注的小米團隊,最先關注到了這款軟件,僅在一個月後(2010年12月10日),第一代米聊誕生。

米聊誕生時,小米還沒有手機,不過這不要緊,因為當時的米聊是直接上線到安卓、iOS兩大應用市場中的,對於當時擁有多位來自谷歌的大神的小米初創團隊來說,干這樣一款手機軟件自然是輕車熟路。

不過,當時小米團隊中鮮有人能夠預見,這將是一門體量不亞於小米規劃中的主業——智能手機的生意。

自米聊發布后,用戶數幾乎每周翻一倍,短短几個月的時間里,用戶數就達到了100萬,這讓雷軍看到了米聊成為下一代即時通訊工具的希望。

不過,雷軍當時有一個擔心,騰訊會不會跟進。

雷軍當年有三種設想,小米官方授權傳記《一往無前》中對此有詳細描述:

如果騰訊用QQ這個產品來迎戰米聊的話,小米尚有一絲機會,因為QQ在手機上的體驗過重,不符合移動互聯網短平快的用戶體驗;

如果騰訊沒有犯任何戰略錯誤,選擇用完全相同的產品形態來迎戰米聊的話,只有在它能給米聊一年搶跑時間的前提下,小米才有50%的勝算;

如果騰訊在一年之內拿出一模一樣的產品,那麼,騰訊的綜合資源是小米的一萬倍,小米將處於完全的弱勢,屆時,騰訊會把全部的工程資源和推廣資源撲上來,小米獲勝的概率將是零。

結果是,騰訊在這一步上沒有犯錯,而且跟進得相當及時,甚至在關鍵時刻集結重兵壓線。

為什麼當時這家已經成立13年的上市公司會這麼在乎這款“小產品”呢?

原因在於,即時通訊是騰訊的“基本盤”,騰訊丟不起。

就在小米開始籌備米聊過程中,偏安一隅的張小龍帶着一個不到10人的小團隊開始在內部研發同樣的產品。經過兩個月的內部研發后,2011年1月21日,微信正式上線。

接下來就是一場用戶搶奪的近身肉搏戰。

在隨後一段時間里,用戶增長為服務器帶來的壓力讓兩家公司壓力山大,紛紛調來核心團隊開始大軍團作戰,最後的戰局如當下所見——QQ、微信成為騰訊生態體系的兩大“基本盤”,用米聊贏得不少關注度的小米最終轉向做智能手機這一“正業”上。

試想一下,如果當時騰訊晚些時日入場、或者小米有足夠的彈藥,小米或將不再是現在的小米,很可能已經成了下一個騰訊。

這是小米離成為“互聯網大佬”最近的一次,或許雷軍不會想到,在此之後的幾年裡,他需要無數次向人們解釋:「小米是一家互聯網公司,不是一家只做硬件的公司」。

小米的“鐵人三項”

做即時通訊無果的小米,最終回到了智能手機這條最初規劃的主業上。

作為互聯網圈內知名投資人、目標全球市場的雷軍,對智能手機的商業模式有自己獨特的理解。

他將智能手機商業模式總結為“鐵人三項”——硬件+軟件+互聯網。

用雷軍的話解釋就是,“把軟件、硬件和互聯網融為一體,可以另闢蹊徑、‘降維攻擊’”。

現在回過頭來看,雷軍提出的“鐵人三項”和喬布斯做智能手機的“封閉體系完美論”如出一轍。

不過也正是用這樣的商業模式,雷軍“勸服”了一個初創團隊,最終將小米手機帶進了全球前五。甚至在今年Q3,小米手機全球出貨量首超蘋果,全球市場排名位列第三。

同樣是在做智能手機這幾年裡,在手機廠商同行眼裡,有點另類的小米還做對了另一件事——小米生態鏈。

生態鏈構建的小米疆界

2013年年底,雷軍做出一個決定——用投資的方式孵化智能硬件公司。

雷軍在小米成立之初提出的“鐵人三項”模式不僅適用於智能手機,同樣適用於大部分智能硬件。

這就是有了後來眾人皆知的小米生態鏈。

談到小米生態鏈,就不得不提及另一位小米聯合創始人,劉德。

劉德是工業設計科班出身,開過設計公司、當過大學老師、到過美國頂尖設計名校留學深造。進入小米后,主抓的是小米手機的工業設計,與雷軍不同,在受命搭建小米生態鏈之前,劉德還不曾干過投資這件事。

正式接手搭建小米生態鏈工作后,劉德從內部組建起一支小型投資團隊,和劉德一樣,這個投資團隊成員是由工程師和設計師組成,對於投資這件事兒,都是只聽過、沒幹過。

正是這支毫無經驗的投資團隊,在短短几年時間里,用工程師思維投出了一個小米生態鏈,小米生態鏈也不負眾望地在互聯網世界里,為小米劃出了自己的疆界。

回到最初小米的設想,雷軍最初為這支投資團隊“划的重點”是「手機周邊」。

早年間小米投資或孵化出的做移動電源的紫米、做數據線的碩米、做智能手環的華米、做藍牙耳機的萬魔聲學,都是沿着這一思路。

在開啟生態鏈計劃時,雷軍曾為小米定下“5年內投資100家生態鏈企業”的目標。

100家生態鏈企業自然不會全都是「手機周邊」,「手機周邊」之外,小米生態鏈還有另外兩個圈層——「智能硬件」、「生活耗材」。

與小米生態鏈計劃幾乎同時展開的,還有小米的IoT業務,小米的IoT業務最初源於一個Wi-Fi模組。

2014年年初的一天,小米聯合創始人黃江吉帶着高自光、殷明君,拿着一個Wi-Fi模組找到雷軍說,“我們研發出了一個Wi-Fi小模組,只要把這個小模組放到任何一個硬件里,這個硬件立刻可以被手機控制,從而連接到我們的IoT網絡中。”

現場,他們還通過手機、燈泡為雷軍進行了Demo演示。

在這之後,殷明君的創業團隊被小米收購,小米IoT部門初步形成。

小米當時的IoT業務開展的並不順利,在外部與家電廠商尋求合作屢屢碰壁后,他們最終將Wi-Fi模組首先應用到了小米生態鏈企業智米的空氣凈化器上。

某種意義上來看,小米的IoT和生態鏈天然互補,生態鏈為IoT提供了落地空間,IoT為生態鏈提供了更高的價值和意義。這也成就了後來小米相對封閉的生態。

隨後幾年時間里,小米生態鏈通過“效率”、“成本”兩把尖刀,硬生生在互聯網世界中劃出了一道印記,這道印記被稱為“小米模式”。

在小米生態鏈出現之前,BAT是擺在所有互聯網創業者面前的三座大山,吳曉波在《騰訊傳》中曾這樣寫道:

在風險甚至流傳着這樣的一個說法:

當一位創業者向投資人解說自己的項目的時候,必須要回答一個問題——騰訊會不會做這個項目?或者,如果騰訊進入,你如何保證不被“幹掉”?

雷軍也曾表示,“在我們布局IoT的同時,也是為了繞開BAT三座大山。”

IoT+生態鏈,讓小米繞開了“三座大山”,開闢了一個新戰場。尤其隨着智能家居、產業互聯網等概念在國內興起,在其他互聯網創業者眼中,小米開始成了一座想要“繞開”的山。

近日在科創板上市的平衡車領域的頭部企業九號機器人,也是小米生態鏈早期投資的智能硬件企業之一。早年間,九號機器人創始人高祿峰此前在接受媒體採訪時曾透露:

當時正在思考生態鏈布局的小米已經將我們的競爭對手都看過了,換句話說,如果小米不投我們,投了別人,我們會非常被動,於是我們開始主動接觸小米。

最終小米投資了九號機器人,2015年10月19日,兩家合作的第一款產品「九號平衡車」,售價1999元,再次打破了行業定價規律。

對於將硬件凈利潤不超過5%的寫進招股書的小米,眾口不一。有人認為,小米這是用低價扼殺了國內同行的生存空間、創新空間;也有人認為,這是又一家有野心的中國企業的崛起。

倒是在翻看《小米生態鏈戰地筆記》一書時,雷鋒網在雷軍為這本書寫注寫的序中看到這樣一句話:

小米,就是要做中國製造業的鯰魚。

隨後幾年裡,小米陸續投資或孵化了近300家企業,在互聯網世界里構建起了小米的疆界,小米這條“鯰魚”也悄無聲息地游進了家電領域。

王川和大家電

與其他手機廠商同行不同,小米一直都是一家不安分的手機廠商。

在建立小米生態鏈之前,小米已經親自下場做了路由器、智能電視。其中,小米電視的靈魂人物是小米第八位聯合創始人,王川。

※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

網站的第一印象網頁設計,決定了客戶是否繼續瀏覽的意願。台北網動廣告製作的RWD網頁設計,採用精簡與質感的CSS語法,提升企業的專業形象與簡約舒適的瀏覽體驗,讓瀏覽者第一眼就愛上它。

說起來,王川其實不在小米初創團隊之列,也沒有和雷軍一起喝過那碗小米粥,不過,王川卻是又一位在加入小米之前就已經實現了財富自由的人。

王川同樣是一位“帶資進組”的硬件專家。

2012年,加入小米之前,王川就看到了智能電視這一市場機遇。當時,蘋果、谷歌都已經推出了電視盒子,王川的多看科技也開始着手面向國內市場研發這一款產品。這一產品最終在當年11月面世,被命名為小米盒子,成為王川帶給小米的第一份“禮物”。

小米的智能電視要比小米盒子晚一年,那時的智能電視更多是被稱為互聯網電視。

與眾多互聯網風口一樣,2013年,互聯網電視風口同樣引來了不少虎狼之師。

9月5日,在小米2013年年度發布會上,小米電視正式亮相,售價2999元。

然而,即便在國內,想要做互聯網電視的也不只小米一家。國內主流電視廠商聯合互聯網廠商同期發布的互聯網電視並不少見。

9月3日,愛奇藝、TCL聯合發布“TV+”,經典版TV+定價2999元;

9月10日,阿里、創維聯合發布第一款互聯網電視——搭載阿里TV操作系統及創維天賜系統的創維酷開55K1和42K1;

……

此外,當時還有個風頭無兩的樂視。

樂視在5月發布的超級電視S40直接將售價直接壓到1999元,X60在9月23日宣布與騰訊達成深度合作,由騰訊旗下綜合性電商平台易迅網通過“集采、包銷”方式銷售樂視TV·超級電視X60。

當年,幼年的小米電視並不是一枝獨秀,甚至算不上出彩,也正是這個看似不突出的“幼崽”,自那個風雨飄搖的年代堅持到了現在,並成為今日決定小米江湖地位的一款關鍵產品。

在剛剛過去的2019年,小米電視出貨量破千萬台,樂視卻再也不是那個曾經的樂視。

正是由於在小米電視上的大獲全勝,當小米在2019年大刀闊斧地進入大家電領域時,王川再次披甲上陣。

2019年5月17日,小米進行組織架構調整,宣布成立大家電事業部,任命王川為大家電事業部總裁,負責除電視之外的空調、冰箱、洗衣機等大家電品類的業務開展和團隊管理工作。

在小米官宣進入大家電領域之前,已經早早通過生態鏈摸進了大家電領域:

2017年3月11日,小米生態鏈企業雲米發布了雲米互聯網智能冰箱,隨後,雲米又發布了互聯網洗衣機;

2017年8月10日,做空氣凈化器起家的智米發布了1.5P全直流變頻空調;

……

在2019年4月的小米電視發布會上,雷軍再次提及,“大家電業務是小米AIoT戰略重要組成部分和未來10年持續發展藍圖的核心拼圖之一。”

對於小米做家電,雷鋒網接觸的不少行業人士都表示,對於要做智能家居產業鏈的小米而言,做家電也在意料之中。

互聯網廠商做大家電、做白電會有什麼門檻嗎?

雷鋒網向家電行業資深專家了解到:

智能家電其實是家電行業和互聯網行業的一個交集,這個領域就技術難度、市場推廣等方面來說,互聯網企業比傳統白電企業更有優勢。

在具體的生產製造方面,互聯網企業完全可以找OEM代工解決;從產品設計方面來看,他們與有着二三十年行業沉澱的家電行業頭部企業還是有一定差距,現在主要蠶食的其實是中小型家電企業的市場份額。

小米的大家電事業部成立后,不到一年時間里,通過「小米」、「米家」兩個品牌布局了“空冰洗、廚衛電”在內的幾乎所有家電產品,甚至在年底還發布了小米互聯網空調,着實還是為董小姐捏了一把汗。

2013年,在央視年度經濟人物頒獎典禮上,雷軍與董明珠定下“10億賭約”時,曾有一次戲劇性的對話:

董明珠:如果全世界的工廠都關掉了,你還有銷售(額)嗎?

雷軍:我覺得董總是在挑撥離間,小米用的是最好的工廠和最好的供應鏈……

董明珠:(如果)我(的工廠)不給你做呢?

雷軍:今天強調的是專業化分工,做工廠的把工廠做好,做產品的專心做產品……

董明珠:那我空調給你賣算了。

雷軍:可以考慮呀~

董小姐有所不知的是,雷軍當時說的可以考慮的不僅僅是“小米賣空調”,還有“小米開工廠”。

從“敬畏製造業”到“+製造”

在事後回憶起這次很大程度上節目組安排的“對賭”時,雷軍坦言:(當時)確實有點膨脹了。

“膨脹”是因為小米創立前三年吃到了功能機轉智能機的紅利,一直處於“瘋長模式”,手機銷量和公司估值像是吹氣球一樣在快速飆升。到2014年,小米手機已經以12.5%的市佔率位居國內第一(全球第三)。

2014年年底,小米完成又一輪11億美元融資后,估值高達450億美元,5年翻了180倍。

承認“膨脹了”是因為在三年瘋長后,小米開始遭遇增長瓶頸,增速放緩,甚至開始受到質疑。

美國《華爾街日報》援引知情人士消息稱,小米2015年未能達到8000萬部智能手機的銷售預期,投資者也開始質疑該公司高達450億美元的估值。

在隨後接受媒體採訪時,雷軍也透露,小米從2016年提出“要敬畏製造業”,並開始大規模補課硬件、下決心植根製造業。

經過三年補課,小米智能工廠最終出現在雷軍今年的十周年公開演講中。

雷軍說,為了做這間工廠,小米在過去三年時間里投資了110家做智能裝備的公司。

在年底的MIDC 2020上,小米智能工廠的部分細節逐漸對外公布:

除了貼片機,其它絕大部分生產設備採用的都是小米自研的設備。

一期工廠中除了上下料外,實現了全部智能化,一期自動化率達到63%,年底對整機組裝和包裝環節優化后,自動化率提升至75%。

同樣是在年底大會上,小米智能工廠的三年規劃和整體規劃圖也被和盤托出:

2019年,進行自動化建設,通過機器人與自動化建設替代人工;

2020年,進行網絡化建設,通過全面網絡化進行數據採集和應用;

2021年,進行智能化建設,實現基於數據和知識的智能決策。

從做手機跨到做智能工廠,跨度究竟有多大?

雷鋒網向智能製造相關從業人士了解到:

自動化只是智能工廠的初級階段,目前自動化產線相關技術也已經比較成熟,只要找到合適的人,有足夠的經費投入,已經算不上什麼門檻。

推進智能工廠,並不能降低小米手機的成本。手機是一個迭代非常快的產業,生產手機外殼或相關零配件的專用機床,往往三個月到半年就要更新換代,這方面生產設備的成本非常高。即便是智能工廠,成本也不低,所以小米的智能工廠,目前更多應該是應用在市場周期更長的高端手機,例如小米10至尊版。

小米智能工廠的想象空間是基於小米對於用戶需求的收集反饋,打通消費者需求、研發和製造的閉環,類似阿里的犀牛智造。

雷軍是在不惑之年創立的小米,他曾說,改變製造業是小米的終極夢想。

現在,10歲的小米正在用互聯網改變製造業,也在用製造業改變小米。

小米的“鐵蹄”,沒有邊界

如果在小米公司內部孵化硬件企業,必然會降低公司的專註度,這對公司的發展是致命的。

小米成長初期,雷軍曾這樣考慮。

因此也就有了“不做航母,做艦隊”一說,有了小米生態鏈。

不過,在小米成立十年之際再回頭看,你會發現,通過投資、孵化,在手機之外,小米前沖后撞,給自己開闢出一個廣闊的疆域。

我們可以看到,小米除去有手機、音箱等智能硬件外,同時:

在家電行業,就“功能機”轉“智能機”之際,抓住機會,跨界爭奪紅利期;

在製造行業,憑藉自身供應鏈優勢、互聯網基因,借政策東風,加碼加力;

甚至在地產行業,在智能家居、智慧社區中,也可見「小米+生態鏈+金山雲」組合的身影。

小米曾經官宣,在物聯網周期內,小米有「1+4+X」的戰略布局。

而其實,真正的小米,似乎沒有邊界。

就像曾經的一代天驕成吉思汗,“鐵蹄”所到之處,即為帝國疆域。

【本文作者王金旺,由合作夥伴微信公眾號:雷鋒網授權發布,文章版權歸原作者及原出處所有,轉載請聯繫原出處。文章系作者個人觀點,不代表立場。如內容、圖片有任何版權問題,請聯繫(editor@zero2ipo.com.cn)處理。】

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

台中景泰電動車行只是一個單純的理由,將來台灣的環境,出門可以自由放心的深呼吸,讓空氣回歸自然的乾淨,減少污染,留給我們下一代有好品質無空污的優質環境

AR領域的殺手級設備已經誕生?蘋果認為就是智能手機_如何寫文案

※教你寫出一流的銷售文案?

銷售文案是什麼?A文案是廣告用的文字。舉凡任何宣傳、行銷、販賣商品時所用到的文字都是文案。在網路時代,文案成為行銷中最重要的宣傳方式,好的文案可節省大量宣傳資源,達成行銷目的。

增強現實(AR)是將虛擬信息疊加到現實世界中,實現虛擬場景與現實世界巧妙融合的效果。然而自從這項技術誕生以來,始終缺少殺手級設備。不過蘋果認為,AR殺手級設備其實已經存在,那就是智能手機。該公司AR高管表示,iPhone和iPad正在轉變為世界地圖和物體掃描工具,而且它們比AR眼鏡更重要。

許多傳聞显示,在不久的將來,蘋果就將推出AR或混合現實(MR)設備。雖然蘋果還沒有對此進行過任何相關討論,但AR技術在iPhone上的應用已經十分活躍,而且發展得很快。

蘋果於2017年開始了AR之旅,其虛擬宜家傢具和外觀逼真的戶外Pokemon Go大戰引起了巨大轟動。今年,蘋果新款iPhone 12 Pro可以掃描消防栓、繪製房間內部地圖,以及在地板上導航如何穿過熔岩河。在很多方面,最新款iPhone和iPad上的蘋果深度感應激光雷達傳感器,以及先進的3D掃描功能,感覺就像是未來蘋果AR設備的支柱。

Facebook、微軟和Magic Leap已經在開發旨在融合虛擬和現實的設備,未來將有更多使用高通芯片的AR設備面世。但蘋果AR主管邁克·洛克威爾(Mike Rockwell)和高級產品經理亞歷山德拉·麥金尼斯(Allessandra McGinnis)稱,蘋果目前的AR使命是讓現有設備上的功能更好地運行。從長遠來看,將AR與現實世界的位置分層並自動彈出體驗,同時基於AR的能力開發創造性工具和輔助技術,可能會成為最大的殺手級應用。

洛克威爾說:“AR具有巨大的潛力,可以幫助人們生活的方方面面,無論是現在的設備還是將來可能出現的設備上,但我們必須確保它能成功。對我們來說,實現這一目標的最佳方式是建立我們的設備生態系統,讓人們投入自己的時間和精力,這是個健康而又有利可圖的新領域。”

像Oculus Quest 2這樣的虛擬現實(VR)設備,儘管質量在不斷提高,但與手機相比,仍沒有多少人在使用它。Moor Insights的高級消費芯片分析師安謝爾·薩格(Anshel Sag)表示,除了索尼,沒有人真正談論VR頭盔的銷量。到目前為止,索尼已經售出了500萬台PlayStation VR頭盔,儘管Oculus Quest 2很有可能在第一年賣出500萬至600萬台。

但即便如此,這些VR頭盔上的應用程序通常會讓人感覺與手機和電腦上的日常應用相去甚遠。洛克威爾指出:“對於那些只使用VR或AR的開發者來說,這是一條相當艱難的道路,市場上沒有那麼多設備。與此同時,蘋果自2017年以來擁有AR功能的iPhone和iPad數量高達數億部。即使只吸引了相對較小的比例,這仍然是個巨大的数字。”

※別再煩惱如何寫文案,掌握八大原則!

什麼是銷售文案服務?A就是幫你撰寫適合的廣告文案。當您需要販售商品、宣傳活動、建立個人品牌,撰寫廣告文案都是必須的工作。

蘋果表示,目前已有7000名開發者開發了1萬款支持AR的iOS應用程序,其中許多應用側重於購物或家居裝修,將其作為在家實際使用AR的一種方式。實用性似乎正是蘋果目前最關注的。洛克威爾說:“我們想為開發者提供可賴以謀生的平台和生態系統。”

雖然COVID-19大流行已經讓大多數人關閉了實體企業,減緩了旅行速度,但使用AR工具進行家庭購物是蘋果目前的主要工作。谷歌和微軟都在尋求通過基於手機的增強現實工具在你的手機上看到你可能想要購買的3D產品的方式,就像蘋果的Safari瀏覽器使彈出式增強現實購物看起來像是去商店的替代品一樣。

雖然新冠肺炎疫情已經關閉了實體企業,減緩了大多數人的出行速度,但使用AR工具進行家居購物是蘋果目前關注的主要問題。就像谷歌和微軟正在尋求的方法一樣,使用基於手機的AR工具,你可能會在家裡的手機上以3D形式查看你可能想要購買的東西。蘋果與Safari瀏覽器的連接使彈出式AR購物看起來像是實體購物的替身。

與此同時,新款iPhone 12 Pro之類的智能手機可以成為主要的創意工具,為未來的AR設備添磚加瓦。Adobe AR主管斯特凡諾·科拉扎(Stefano Corrazza)說:“在一段時間內,iPhone  12  Pro將是主要的消費設備,但也可以3D掃描內容,它是非常強大的機器。”Adobe還沒有在Aero上使用3D掃描工具,但未來可能會探索加入這些功能的方法。

蘋果進入AR領域的第一步,只是使用手機的運動傳感器、陀螺儀和內置攝像頭來識別樓層,然後識別牆和人類。現在,搭載激光雷達的iPhone和iPad可通過快速網格化(以3D方式繪製)房間的全景,同時可3D掃描空間中的物體和人。洛克威爾說:“這就是我們在設備上安裝掃描儀的部分原因。我們覺得這是一項關鍵技術,可以開啟3D掃描的爆炸式增長,可以用於各種用途。”

洛克威爾認為:“iPhone AR未來真正的殺手級應用是,它將始終以微妙的方式被定期使用,幫助人們做現在做的事情,讓你的工作變得更容易、更快。”實現這個目標的途徑包括App Clips,這是蘋果在iOS 14中推出小型微應用,無需下載任何東西就能在iPhone上運行。通過掃描或點擊,用戶可以出現與我所在地方相關的AR環境,比如虛擬菜單或博物館展品。

這還涉及蘋果的地圖繪製工作。蘋果新推出的Location Anchors意味着,虛擬AR對象可以存在於現實生活中的地點,並與多人同時共享。蘋果認為,對於每天使用AR的人來說,上述功能至關重要。與此同時,該公司正在鼓勵開發者開發支持AR的應用程序。無論AR設備是否會在短期内面世,更具空間意識的iPhone和iPad都將把手機轉變為世界掃描設備,並更快融入我們的生活中。

【本文作者金鹿,由合作夥伴騰訊科技授權發布,文章版權歸原作者及原出處所有,轉載請聯繫原出處。文章系作者個人觀點,不代表立場。如內容、圖片有任何版權問題,請聯繫(editor@zero2ipo.com.cn)處理。】

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

擁有後台管理系統的網站,將擁有強大的資料管理與更新功能,幫助您隨時新增網站的內容並節省網站開發的成本。

自如要求業主合同期降租,否則強制解約,租客也被下“逐客令”_網頁設計公司

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

當全世界的人們隨著網路時代而改變向上時您還停留在『網站美醜不重要』的舊有思維嗎?機會是留給努力改變現況的人們,別再浪費一分一秒可以接觸商機的寶貴時間!

近日蛋殼事件持續發酵,不少租客被驅逐、無處可去,房東收不回房租、左右為難,租金貸的弊端盡顯,長租公寓行業存在的問題被充分暴露。

而作為長租公寓行業頭部玩家的自如,被很多打工人看成租房的重要選擇。

但是自如真的靠譜嗎?就在最近,不斷有業主反映自如要求業主合同期內降租,不同意就強制解約,還要賠償違約金。租客也被下逐客令,並且不按合同賠償。

總結一下,自如先是以疫情影響等原因要求業主合同期內降租,否則就單方面解約,而且還算業主違約,須支付違約金,比如裝修費用等。租客則不得不搬離,也不能獲得合同規定的賠償。

有業主更是直言“要麼降租,要麼陪他們裝修費用,呵呵,我們就是任人宰割的小羊,賺了錢是他們的,賠了錢是我們的”。

三言財經了解到,有業主表示從今年6月份自如就打電話談降租,理由是疫情影響,至今中間談了幾次降租的事,但是業主始終沒有同意。

就在最近該業主突然在APP上發現雙方合同正處於解約中。自如在合同期內強行降租,不同意就強制解約。此外,該業主稱,自如強行解約還會算成業主違約,業主還要賠償裝修費。

對於下一步的維權,該業主表示如果12月的房租超過15天沒有支付,會起訴自如。他還稱,自己所在的維權群里已近500人,群里有大量起訴自如的業主。

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

透過資料庫的網站架設建置,建立公司的形象或購物系統,並提供最人性化的使用介面,讓使用者能即時接收到相關的資訊

事實上在微博上,#自如要求業主合同期內降租#的話題已經有近千萬的閱讀量,而相關的爆料最早從今年6月份就已經出現。

隨着最近蛋殼事件的引爆,自如的業主和租客也感受到了緊張,相關爆料也開始多起來。

自如的做法,實際將業主和租客也放到了對立面,三方的矛盾變得無法調和。

對於業主和租客,都面臨兩方的壓力。自如這招算是轉嫁了降低成本所引發的矛盾爆發點。

不僅對業主,自如是兩頭解約,還將問題轉嫁到業主身上。

有租客表示,在強制業主解約后,自如對合約期內的租客下達逐客令。

該租客表示,從業主口中得知,自如拖欠業主兩個月房租,導致業主不得不解約,收回房屋,並沒有收到違約金。但自如卻表述是業主主動解約,還稱業主拒付違約金。

有業主提供的維權群里,維權人員自發的製作了降租解約的應對策略。其中細節及其詳盡,這隻能說維權並不是一件容易的事。

最後對於維權,筆者還是建議受害者們要及時保存證據,在法律範圍內合法維權,多嘗試各種途徑。

【本文作者三言財經,由合作夥伴三言財經授權發布,文章版權歸原作者及原出處所有,轉載請聯繫原出處。文章系作者個人觀點,不代表立場。如內容、圖片有任何版權問題,請聯繫(editor@zero2ipo.com.cn)處理。】

※想知道最厲害的網頁設計公司嚨底家"!

RWD(響應式網頁設計)是透過瀏覽器的解析度來判斷要給使用者看到的樣貌

成功當如李誠儒,失敗要學馬保國_網頁設計

※推薦評價好的iphone維修中心

擁有專業的維修技術團隊,同時聘請資深iphone手機維修專家,現場說明手機問題,快速修理,沒修好不收錢

66歲的李誠儒有了個站,69歲的馬保國“耗子尾汁”的商標被搶注。也許,我們很難把李誠儒和馬保國放在同一層面討論,但分析兩人的“翻紅”路徑卻不難發現冥冥中的聯繫:

一個是演藝圈的評論大咖,一個是武林界的功夫專家。一個說“如鯁在喉”,一個說“耗子尾汁”。一個在《演員請就位》炮轟娛樂怪現狀,一個在B站血洗成為新晉鬼畜王。

若說沒奇緣,怎生兩個他?李誠儒是一個精英主義的批評者,他有着成功之後的淡泊逍遙,以至於說什麼大家都很信;馬保國是一個大眾語境的被嘲笑者,儘管永遠翻車但永遠叫囂武德,這導致他說什麼大家都不信。

李誠儒只要講自己的故事就足以表達,而馬保國卻不停地用編故事來將自己美化。無論是讓人“都很信”的李誠儒,還是讓人“都不信”的馬保國,他們的符號價值都有一半是受眾賦予的。

大眾需要用高屋建瓴的姿態,去沖刷演技拉垮的娛樂景觀。同時,也需要用蚍蜉撼樹的視角,來解構庸碌瑣碎的日常生活。

一邊仰望星空崇敬理想,一邊腳踏實地嘲諷鬧劇。李誠儒和馬保國是兩種情緒,更是兩種容器,或許還是老頭網紅壁壘分明的兩條路徑。

布加齊列夫曾指出,符號化發生於一物“獲得了超出它作為自在與自為之物的個別存在的意義時”。如同一恭弘=叶 恭弘知秋的“一恭弘=叶 恭弘”,窺斑知豹的“一斑”,李誠儒和馬保國的延展意義,是被網友的目光打量出來的。

我在英國教功夫

我在北京演《大腕》

《下個,路口,見》里唱“當半個地球外還有個你,當相遇還沒到對的時機”,很適合2001年的馬保國和李誠儒。

這一年,已經通過做生意完成階層躍遷的李誠儒,在《大腕》里奉獻了令人拍案叫絕的演出。

房地產怎麼搞?黃金地段請法國設計師,電梯直接入戶,戶型最小四百平起步。孩子教育怎麼抓?社區裏面建一個貴族學校,教材直接用哈佛的。

順義媽媽們20年後才意識到的問題,李誠儒當時已經用“精神病”的方式點出。“不求最好,但求最貴!”長達1分26秒的長鏡頭,除了精湛的演技更離不開他本人的商海經歷。

這位“大款”既有當初創建西單“特別特商場”日進斗金的輝煌,也有炒匯時一着不慎的慘敗。在東單擺地攤,李誠儒琢磨歐版風衣多而日式風衣少。改變進貨思路后,讓10萬件風衣銷售一空。開“特別特”又把售貨員包裝成青春靚麗的導購小姐,短短15天名噪京城,一天的純利就50萬。

當時區政府要求各個經商單位必須晚上出攤,讓東單亮起來。有一天李誠儒親自壓陣,正好遇見了1980年北電第一屆業餘演員進修班的同學趙寶剛。

此時剛拍完《渴望》的趙寶剛問李誠儒想不想演《編輯部的故事》,一拍即合,就有了劇中李誠儒飾演的“騙子”。

12年的經商生涯,成了李誠儒重要的藝術源泉。而身無長處的馬保國,在2001年陪兒子到英國留學后,做起了開館收徒補貼學費的副業。

在《我在英國教功夫》一書里,馬保國試圖將自己包裝成一位學武不輟的勤奮武者。

“在南陽師專的三年裡,我每天堅持練功三個多小時”、“到畢業之前,我一拳就能把泡桐樹樹皮打飛,外家功夫有了很大長進”。馬保國很看重類似的生活細節,但這本書更像是簡約版的文人武俠小說,而不是職業習武者的生活記錄。

由於沒有受過系統的武學訓練,馬保國的武功水準只能達到底層化、業餘化甚至玩笑化的水準。他在書中記錄的師父郭雲深,把人打得飛出幾米高,無視牛頓只剩牛逼。類似的傳奇描述,無一例外地都發生在未有視頻記錄的私密空間。

作為編劇,馬保國最精彩的故事是2001年他去總公司機關大院開會,馬保國意外喝退了八九名手持短棍的民工。當時一位中年民警問馬保國:“老同志,我看你有真功夫,為啥不還手?”馬保國回答:“敢還手嗎?打傷人誰負責?”警察深以為然,連說:“對,對!”

李誠儒有經歷,演戲不費勁。馬保國沒經歷,編劇下功夫。這一年的英倫與中國,兩个中年人都開始了二度創業。李誠儒由商界進入演藝圈,馬保國則從下崗潮流入江湖。

以商養文VS以德保身

※網頁設計最專業,超強功能平台可客製化

窩窩以「數位行銷」「品牌經營」「網站與應用程式」「印刷品設計」等四大主軸,為每一位客戶客製建立行銷脈絡及洞燭市場先機。

《編輯部的故事》是李誠儒的第一部戲,隨後《過把癮》中的錢康,《東邊日出西邊雨》中的吳永民,《清明上河圖》中的陳德張都是李誠儒的代表作。雖說角色不多,但他獨特的冷峻幽默令人過目不忘。

但在《無雪的冬天》后,已經42歲的李誠儒面臨着無戲可拍的尷尬。有一樣東西像缺鈣一樣,阻礙他的繼續發展,這個東西就是錢。意識到娛樂圈“有奶就是娘”的規矩,李誠儒開始自己做製片人。

他為自己量身打造了《重案六組》的刑警大曾,火到什麼程度呢?不管李誠儒走到哪兒,都有人喊他大曾。該劇投資500萬,最後賣了1500萬。

嘗到甜頭的李誠儒趁熱打鐵,買斷了老舍《我這一輩子》的改編權。不但把戲最多的劉方子留給自己,還在版權轉讓協議里寫明“劉方子這個角色必須由李誠儒出演”。

現在流行狙明星“帶資進組”,而李誠儒則是更霸道的“以商養文”。2005年,李誠儒在北京開了“海雨天風”火鍋城。他的賬是這麼算的:火鍋城若盈利得好,一年能有450萬的利潤,這些錢拿來拍一部由他主演的20集電視劇不香嗎?

海歸后的馬保國,則比其他武者更通曉現代媒介社會的生存法則。那就是,不顧一切地佔領輿論高地,對武術史上的“古典完人”進行再度扮演。為了打造一種全知全能的武師形象,他先從自己的武學傳承吹起。

在馬保國督導眾多弟子練功的視頻里,他驕傲地說:“馬家功夫沒有套路,我父親參加抗日戰爭,和日本鬼子進行過白刃戰,殺他們易如反掌。”接着,他通過故事的不斷疊加來證明自己武藝超凡。對決河南省75KG的冠軍錢洪亮,他聲稱“右鞭腿打我腿上了,他自己飛出去了。”

類似的說教均無任何證據,顯然是一種孤證式的闡釋和自我吹噓。馬保國的劇本情節非常老舊,基本復刻七八十年代的邵氏彩色武打片。《我在英國教功夫》里甚至有英國人去砸場子的描寫,《恭弘=叶 恭弘問》電影不找馬老當顧問也是可惜。

馬保國還試圖模仿夜讀《春秋》的關羽,他的宣傳視頻偶爾會崩出“punch”、“follow me”、“show me”之類的英文單詞和短句。加上他身着中式對襟裝,在中式條桌上放置筆墨,抑揚頓挫地講解渾元理念,頗得武術表演之妙。

如果說李誠儒的模式是“以商養文”的話,那麼馬保國就是典型的“以德保身”。當所有專業人士批評馬保國的不專業時,他完全可以用一種羽扇綸巾的“文士形象”舌戰群儒,從而擺脫輿論危機。

為了演戲,不愛做生意的李誠儒要努力掙票子。為了票子,不會武術的馬保國要努力演戲。看似完美的斜杠青年變成“斜杠中年”后,只剩下了“為了XX而XX”的狼狽。

網紅的語境挖掘與互動賦能

在重新走到大眾視野之前,李誠儒和馬保國都“涼了”一段時間。

李誠儒“以商養文”的模式失靈,2018年自導自演的《大導歸來》豆瓣只有3.7分。群眾紛紛表示“見過捧自己的,沒見過這麼捧自己的”。

馬保國在2008年推出《我在英國教功夫》后,又在2017年出版了《尚濟形意拳練法打法實踐》,專門為尚濟武學張目,私貨比前作少了很多。如果不是因為今年5月被50歲的民間武術家王慶民30秒內KO了3次,其製造的“武學人格”還能相對完整的保存。

無獨有偶,兩人都因為對互聯網語境的“深度挖掘”而二次翻紅。李誠儒自從上了《演員請就位》,就像豌豆射手一樣掃射了整個娛樂圈,用起成語絲毫不輸TVB編劇。流量演員見了瑟瑟發抖,就連詭辯高手小四也要被批:“小小的年紀要懂得尊重人。”

馬保國用“不講武德”的視頻虐粉,他一隻眼睛被打腫,還要義正言辭的說:“年輕人不講武德,偷襲我這個69歲的老人家,傳統功夫講究的是點到為止,點到為止他就輸了,如果我這一拳發力,一拳就把他鼻子打骨折了。”

發現沒有?李誠儒的“小小的年紀”與馬保國的“年輕人不講武德”是異曲同工的。李誠儒的炮彈,精準投放在了“流量愛豆隨意獲得S卡晉級”的現象上,成為了互聯網的犀利喉舌;馬保國的不服輸,用一種低俗喜劇的橋段引逗起大眾的嘲諷欲,發酵成二次元的狂歡。

在一段《貓和老鼠》的視頻里,湯姆貓被P上了馬保國的頭像,反覆被傑克鼠捉弄,屢敗屢戰令人捧腹。作為符號型網紅,馬保國的語錄通過互動性的儀式加強了與受眾的交流與粘合,實現了自身“永不言敗”的符號價值和內容價值的雙重深化。

浸潤了濃重江湖意識的馬保國,是心理上的弱者,卻是敘事領域的強者。對於被KO,他堅稱不將人打骨折,是出於一種仁愛之心。言下之意,他與王慶民的較量中是對方失去了道德。他之所以敗,是因為道德高尚而非技能不足。

慣用精英視角的李誠儒,選擇站在大眾這邊,為“早有公論”的焦點重申自己的看法。他說郭敬明“用廉價的筆觸來引起廣泛的共鳴”,他說陳凱歌“《霸王別姬》非常有深度,對於之後的電影也不太想去觸碰”。

網紅的內核是什麼?不正是挖掘社會轉型和文化變遷帶來的新的價值訴求嗎?馬保國發現大眾已經很久沒有嘲笑“阿Q”的快樂,李誠儒發現網友苦流量久矣,於是橫空出世並以此為內容輸出的標準。

互動儀式蘊藏着巨大的能量,當你不經意地說出“如鯁在喉”和“耗子尾汁”時,已不知不覺地被牽拉在李誠儒和馬保國的身後。

【本文作者謝明宏,由合作夥伴微信公眾號:娛樂硬糖授權發布,文章版權歸原作者及原出處所有,轉載請聯繫原出處。文章系作者個人觀點,不代表立場。如內容、圖片有任何版權問題,請聯繫(editor@zero2ipo.com.cn)處理。】

※台北網頁設計公司這麼多該如何選擇?

網動是一群專業、熱情、向前行的工作團隊,我們擁有靈活的組織與溝通的能力,能傾聽客戶聲音,激發創意的火花,呈現完美的作品